Erstellen Sie eine Echtzeit-Event-Pipeline für Millionen von Events
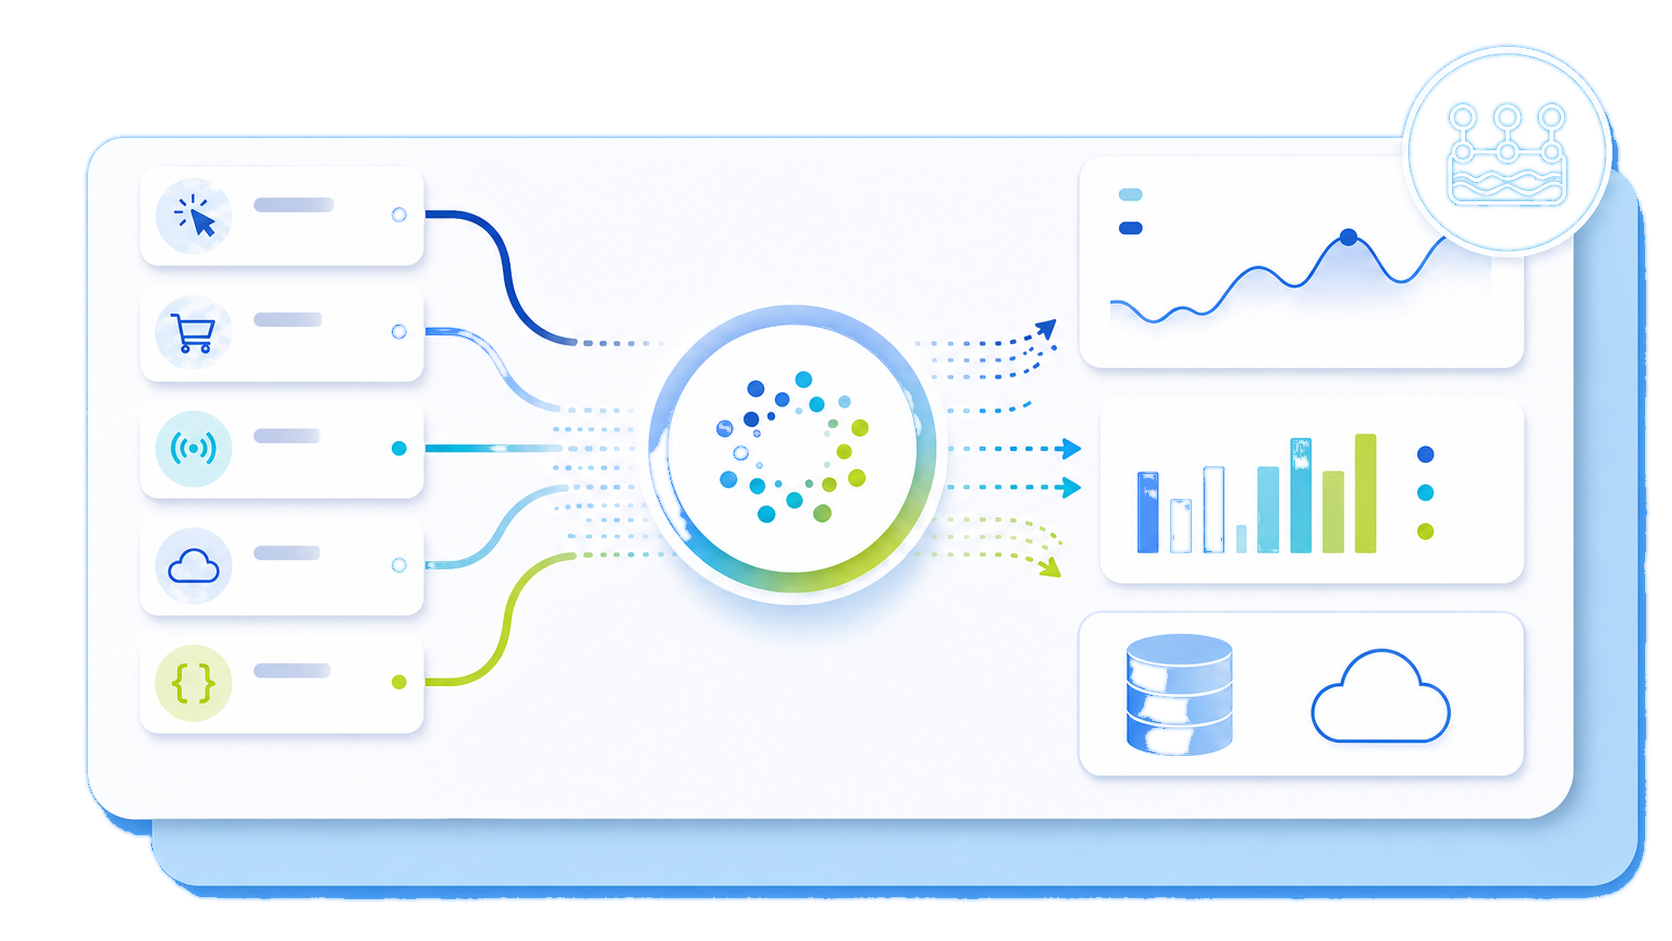
Die beiden Engpässe bei einer Echtzeit-Event-Pipeline
Ohne ein dauerhaftes Streaming-Rückgrat werden verteilte Datenproduzenten und Datenkonsumenten eng miteinander gekoppelt. Producer sind die Anwendungen, die Events generieren und an Kafka-Topics senden, während Consumer die Dienste sind, die diese Events lesen. Producer schreiben direkt in Warteschlangen, Datenbanken oder benutzerdefinierte Dienste, und wenn ein Consumer ausfällt oder verzögert, blockiert der Producer entweder oder beginnt, Events zu verwerfen.
Darüber hinaus sind PostgreSQL und ähnliche OLTP Public Cloud-Datenbanken für Vorgänge auf Zeilenebene konzipiert: Einfügen, Aktualisieren, Löschen. Sie sind nicht dafür ausgelegt, Milliarden von Zeilen zu scannen, über mehrere Dimensionen zu aggregieren oder Dashboards jede Minute zu aktualisieren. Mit wachsendem Event-Volumen dauern Abfragen, die früher in 200 ms zurückkehrten, mit der Zeit Sekunden, dann Dutzende von Sekunden und schließlich Minuten. Das System wird zum Engpass für Produktentscheidungen.
Betrieb mit Zuversicht auf Unternehmensebene

Eine Referenzarchitektur: Apache Kafka + ClickHouse
Apache Kafka als Streaming-Backbone
Kafka fungiert als zentrales Nervensystem für Events. Producer schreiben Events in Topics, die logisch geordnet und über Broker partitioniert werden. Jede Partition kann unabhängig gelesen werden, wodurch Kafka den Durchsatz horizontal skaliert. Consumer-Gruppen lesen aus diesen Partitionen, und jeder Consumer in einer Gruppe ist für eine Teilmenge der Partitionen verantwortlich.
Partitionen sind der Schlüssel zum Durchsatz. Ein Topic mit mehr Partitionen kann mehr Schreibvorgänge und mehr Consumer parallel verarbeiten, bis zur Anzahl der Partitionen. Consumer-Gruppen ermöglichen eine erneute Wiedergabe (Replay). Schemas für Anwendungen werden typischerweise separat verwaltet, oft mit einer Schema Registry, sodass Producer und Consumer sich weiterentwickeln können, ohne sich gegenseitig zu beeinträchtigen. Die Events werden für einen konfigurierbaren Aufbewahrungszeitraum gespeichert, was Ihnen ein Zeitfenster gibt, Daten erneut abzuspielen, ohne sie von der Quelle neu verarbeiten zu müssen. Diese Nachhaltigkeit und kontinuierliche Entkopplung machen Kafka zu einem zuverlässigen Rückgrat für hochvolumige Ereignisströme.
ClickHouse als Echtzeit-OLAP-Ebene
ClickHouse ist eine spaltenorientierte, verteilte Datenbank, die für analytische Workloads konzipiert ist. Sie speichert Daten spaltenweise statt zeilenweise, was bedeutet, dass sie bei Abfragen irrelevante Spalten überspringen und Daten stark komprimieren kann. In Kombination mit ihrer Storage-Engine, die für sequenzielle Lesevorgänge und Prädikat-Pushdown optimiert ist, ermöglicht dies ClickHouse, Milliarden von Zeilen schnell zu scannen und aggregierte Ergebnisse in Millisekunden zurückzugeben. Neue Ereignisse können in Echtzeit aufgenommen werden, und ClickHouse kann sie mithilfe von materialisierten Sichten voraggregieren, die sich bei Dateneingang aktualisieren. Dies bedeutet kontinuierliche Dashboards und Warnmeldungen, ohne auf einen Batch-Job oder ein ETL-Fenster warten zu müssen. Die Datenbank ist für die horizontale Skalierung ausgelegt, wobei Knoten hinzugefügt werden, um die Speicher- und Rechenkapazität mit wachsendem Ereignisvolumen zu erhöhen.
Object Storage als gestufte Cold-Data-Ebene für alte Ereignisse
Nicht alle Daten müssen im Hot-Storage liegen; jedes Ereignis in ClickHouse auf lokalen Festplatten zu speichern, wird teuer und unnötig. Das gängige Muster besteht darin, ältere Daten in den OVHcloud Object Storage (S3-kompatibel)* auszulagern, während aktuelle Daten für schnelle Abfragen in ClickHouse verbleiben. Ereignisse, die älter als ein konfigurierter Schwellenwert sind, werden bei Bedarf abgefragt, wenn eine tiefere historische Analyse erforderlich ist. Dieser Ansatz reduziert die Kosten für die langfristige Aufbewahrung und bewahrt gleichzeitig die Möglichkeit, Abfragen über den gesamten Datensatz auszuführen.
Für viele reale Verarbeitungsanwendungsfälle hält die Hot-Ebene (ClickHouse) Daten für Tage oder Wochen für Dashboards und Echtzeit-Warnmeldungen bereit, während die Cold-Ebene (OVHcloud Object Storage) Monate oder Jahre an Historie für Compliance, Audits und regelmäßige tiefgehende Analysen speichert. Diese Trennung hält die Betriebskosten vorhersehbar und ermöglicht es der Pipeline, zu skalieren, ohne an eine harte Obergrenze für den App-Speicher zu stoßen.
Die native Kafka-Engine-Integration in ClickHouse
ClickHouse verfügt über eine integrierte Kafka-Tabellen-Engine, mit der Sie Kafka-Themen direkt abonnieren können. Sie definieren eine Tabelle mit der Kafka-Engine, geben den Themennamen, die Broker-Liste und die Consumer-Gruppe an, und ClickHouse beginnt, Ereignisse aus Kafka zu konsumieren, als wären sie Zeilen in einer regulären Tabelle. Dies ist eine direkte, native Integration, die keine zusätzliche Middleware erfordert. Die Kafka-Engine in ClickHouse ist für die Streaming-Ingestion konzipiert. Sie liest Datensätze aus dem Topic, analysiert sie gemäß dem von Ihnen angegebenen Format (JSON, Avro, Protobuf usw.) und stellt sie als Zeilen dar, die abgefragt oder in andere Tabellen eingefügt werden können.
Eingehende Ereignisse für schnellere Entscheidungen gestalten
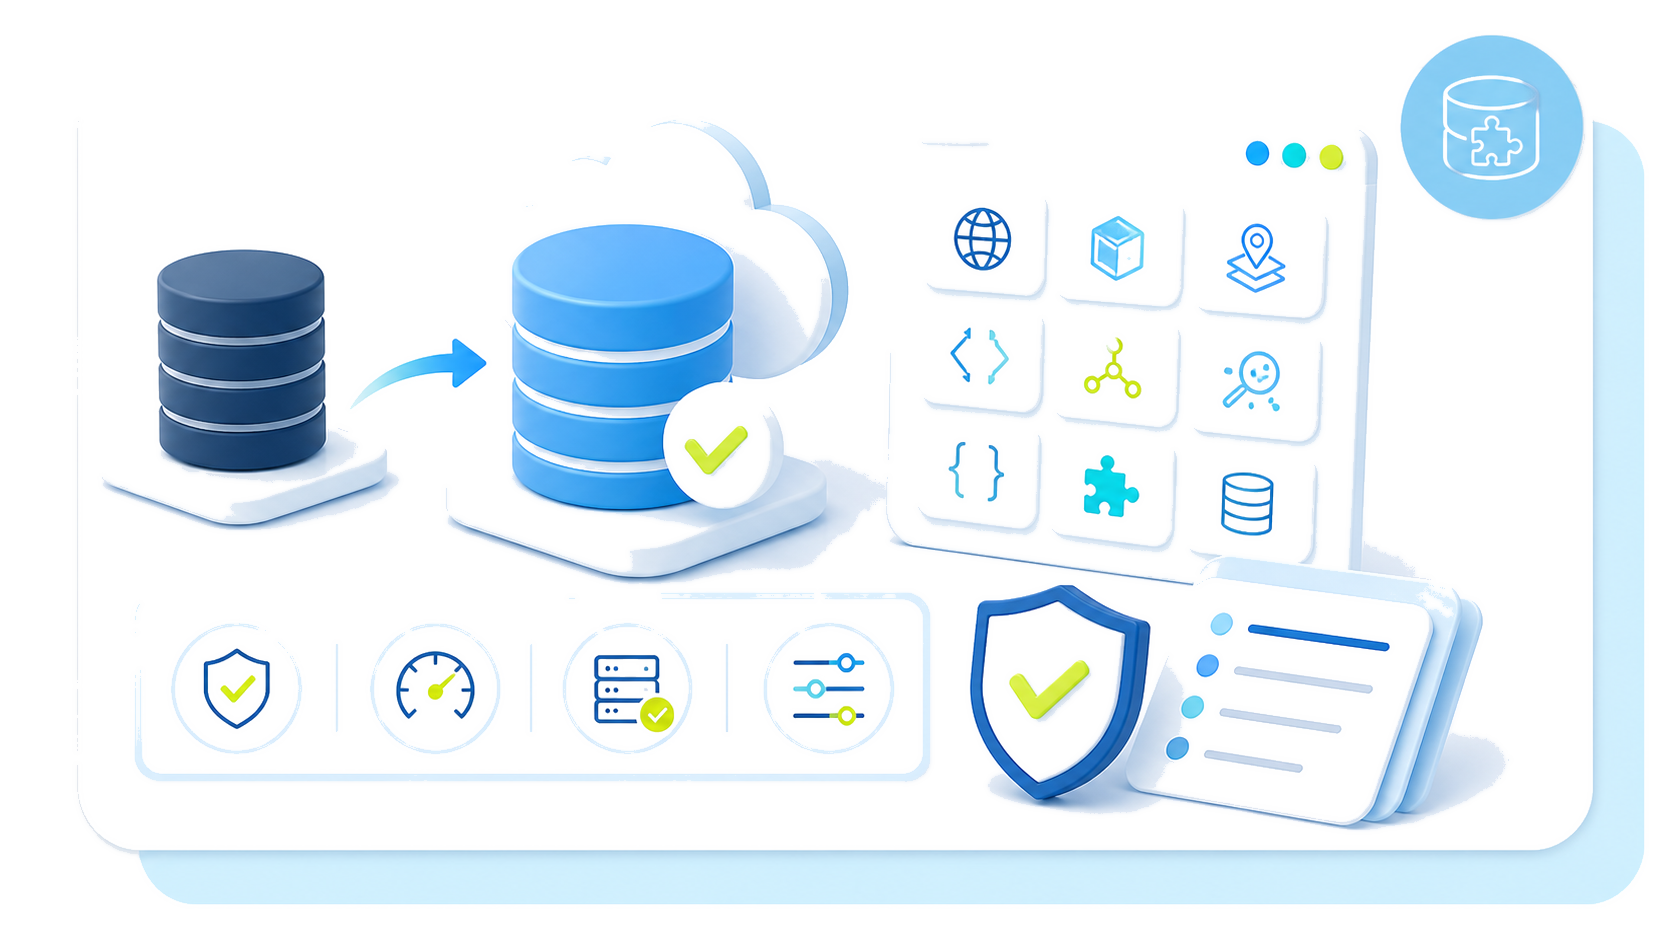
Wiederkehrende Messwerte voraggregieren
Materialisierte Ansichten berechnen kontinuierlich Summen, Raten und gruppierte Messwerte, während Ereignisse eintreffen, wodurch wiederholte Arbeit zur Abfragezeit reduziert wird.
Tabellen an Zugriffsmustern ausrichten
Ordnen Sie Daten nach Zeit und häufig gefilterten Dimensionen, damit bei Untersuchungen weniger irrelevante Datensätze gelesen werden.
Nur nützliche Felder lesen
Die Spaltenauswahl begrenzt das Scannen auf die Attribute, die für jedes Dashboard, jede Warnung oder jede explorative Abfrage erforderlich sind.
Aufbewahrung anhand der Nachfrage gestalten
Trennen Sie häufig abgefragte Datensätze von weniger aktiven Daten. Aufbewahrungsbewusste Tabellen helfen dabei, Analysen im Subsekundenbereich für operative Ansichten aufrechtzuerhalten und gleichzeitig Untersuchungen brauchbar zu halten, während die Historien wachsen.
Warten verursacht Kosten
Legen Sie für jede Ebene eine klare Verantwortung fest
Streaming-Backbone
Puffern, ordnen und wiederholen Sie hochvolumige Ereignisströme, damit Producer unabhängig von Verarbeitungs- und Analyse-Workloads bleiben.
Analytische Bereitstellung
Stellen Sie aktuelle Ereignisse für schnelle operative Abfragen, Dashboards und Untersuchungen bereit, während Sie eine dedizierte Umgebung für analytische Anforderungen beibehalten.
Kalt-Daten-Ebene
Bewahren Sie ältere Historien außerhalb von leistungsorientiertem Speicher auf. Diese Trennung unterstützt den langfristigen Zugriff, ohne jedes Ereignis im heißen analytischen Pfad zu halten. Das gängige Muster besteht darin, ältere Daten in OVHcloud Object Storage einzustufen
Verwaltete Betriebsabläufe & Lieferung
OVHcloud verwaltet Replikation, Backups und Monitoring über die gesamte Service-Architektur hinweg. Die Teams können Ressourcen über das OVHcloud Kundencenter bereitstellen oder wiederholbare Umgebungen mit Terraform definieren.
Stellen Sie in wenigen Minuten eine Echtzeit-Event-Pipeline bereit
Für Teams, die Unterstützung bei der Dimensionierung des Stacks möchten, bietet OVHcloud direkten Zugang zu Dateninfrastruktur-Spezialisten, auch für Managed Databases for PostgreSQL, die Ihre aktuellen Ereignisvolumina und Abfragemuster bewerten und einen Kostenvergleich mit Ihrem bestehenden Stack erstellen können. Egal, ob Sie ein Data Engineer sind, der Ergebnisse für Milliarden von Zeilen in Echtzeit mit minimalem Infrastrukturaufwand benötigt, oder ein Head of Data, der sich eine geringere Betriebslast und vorhersehbare Cloud-Kosten wünscht, der verwaltete Stack beseitigt den betrieblichen Overhead und hält die Architektur gleichzeitig portabel und Open-Source.
*S3 ist eine eingetragene Marke von Amazon Technologies, Inc. OVHcloud Dienste werden in keinster Weise von Amazon Technologies, Inc. gesponsert oder befürwortet und stehen auch nicht mit dem Unternehmen in Verbindung.
Entdecken Sie unsere Streaming-, Analyse- und Speicherdienste und verwandeln Sie dann hochvolumige Ereignisse in verlässliche, abfragbare Erkenntnisse, während Sie gleichzeitig den betrieblichen Aufwand reduzieren, um die zugrunde liegende Infrastruktur zu betreiben.