Infra as a Service

Bewältigen Sie Verkehrsspitzen ohne Ausfallzeiten und skalieren Sie in Minuten
Halten Sie Ihre Dienste während geplanter Spitzen und unerwartetem Wachstum online. Platzieren Sie einen verwalteten Load Balancer vor einer On-Demand-Compute-Instance-Flotte und erweitern Sie dann die Kapazität, ohne Ihre Anwendung zuerst neu gestalten zu müssen. 
Domainnamen Illustration

Unterscheiden Sie echte Nachfrage von Angriffen vor der Skalierung
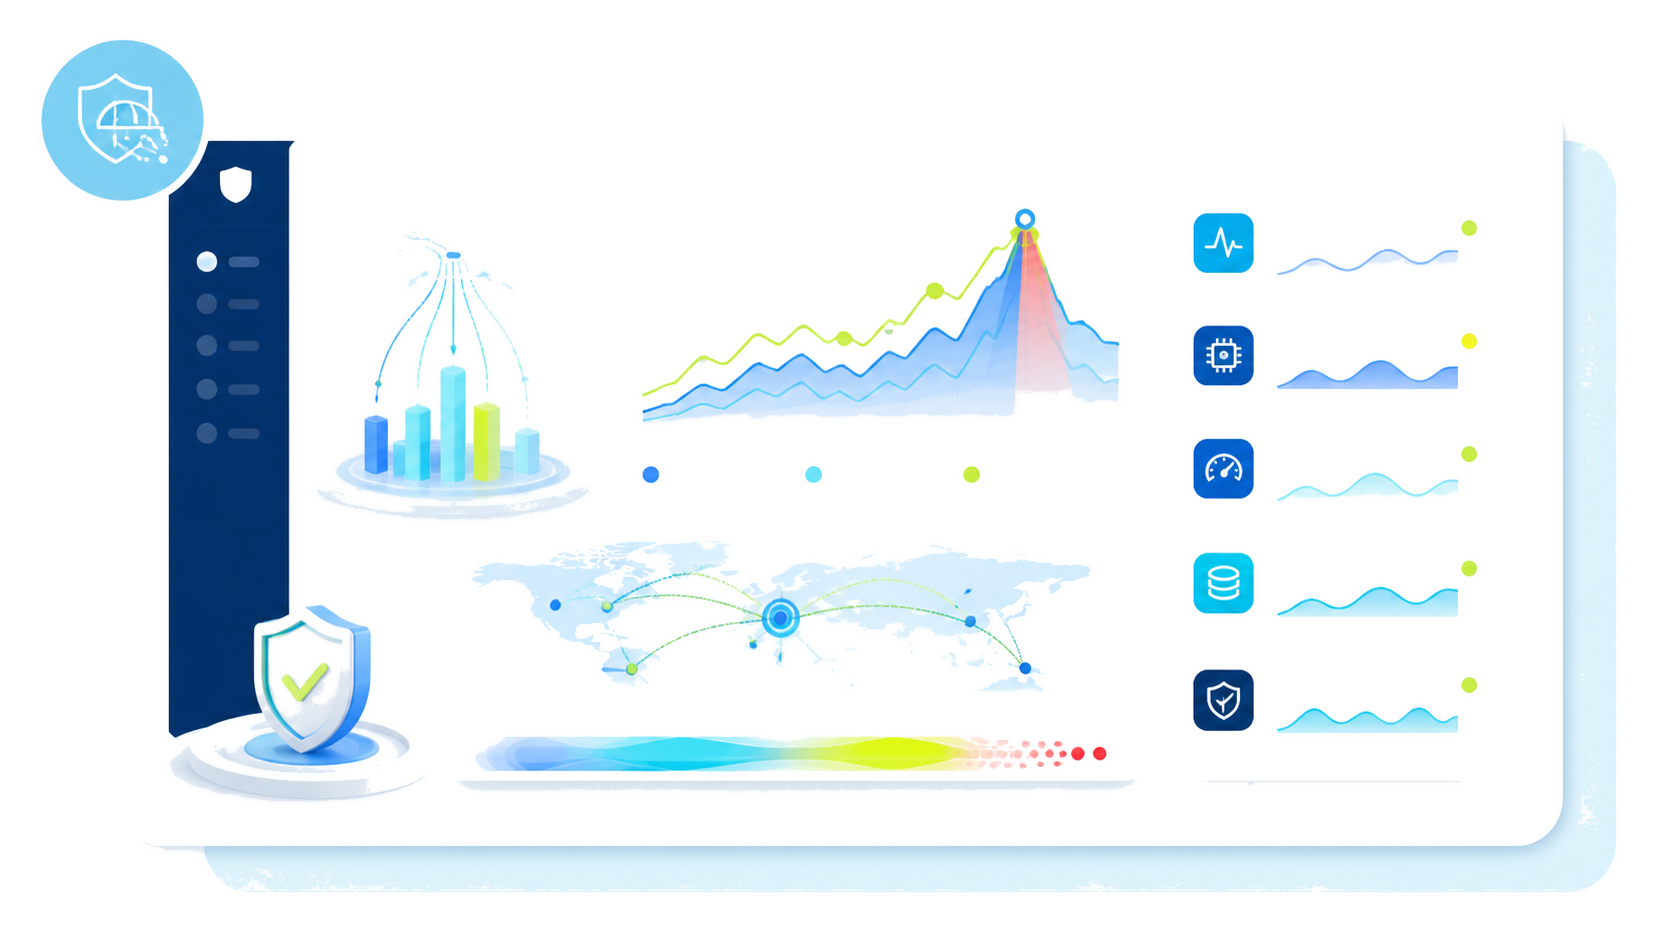
Lesen Sie die Geschichte hinter jedem plötzlichen Verkehrsspitzenwert. Anfragerate, CPU, Latenz und Verkehrsform bieten die technische Tiefe, die erforderlich ist, um echte Benutzer, Fehler oder feindselige Aktivitäten zu erkennen. Um Verkehrsspitzen ohne Ausfallzeiten zu bewältigen, verteilen Sie den eingehenden Datenverkehr, fügen Sie Kapazität hinzu, nutzen Sie Caching und wenden Sie Datenbankoptimierung an. Anti-DDoS-Schutz bewältigt bösartige Datenströme. Dieses Verständnis hilft dabei, Verkehrsspitzen zu bewältigen, Website-Ausfallzeiten bei hohem Datenverkehr zu verhindern und Abstürze oder unnötige Abstürze durch unangemessene Skalierung zu vermeiden.
[object Object]

Messbare Schutzmaßnahmen für Verkehrsspitzen

Erhalten Sie 99,99 % SLA für Compute und Load Balancing sowie Anti-DDoS-Schutz bis zu 10 Tbps
99,99 % SLA-Serviceverpflichtung
99,99 % Serviceverpflichtung
Anti-DDoS-Schutz zur Schadensbegrenzung
Inklusive Schadensbegrenzung
Lastkapazitätsgrenzen
Veröffentlichte Lastgrenzen

Bauen Sie Ausfallsicherheit für Routing, Compute und Daten auf

Sorgen Sie dafür, dass Anfragen am Einstiegspunkt in Bewegung bleiben

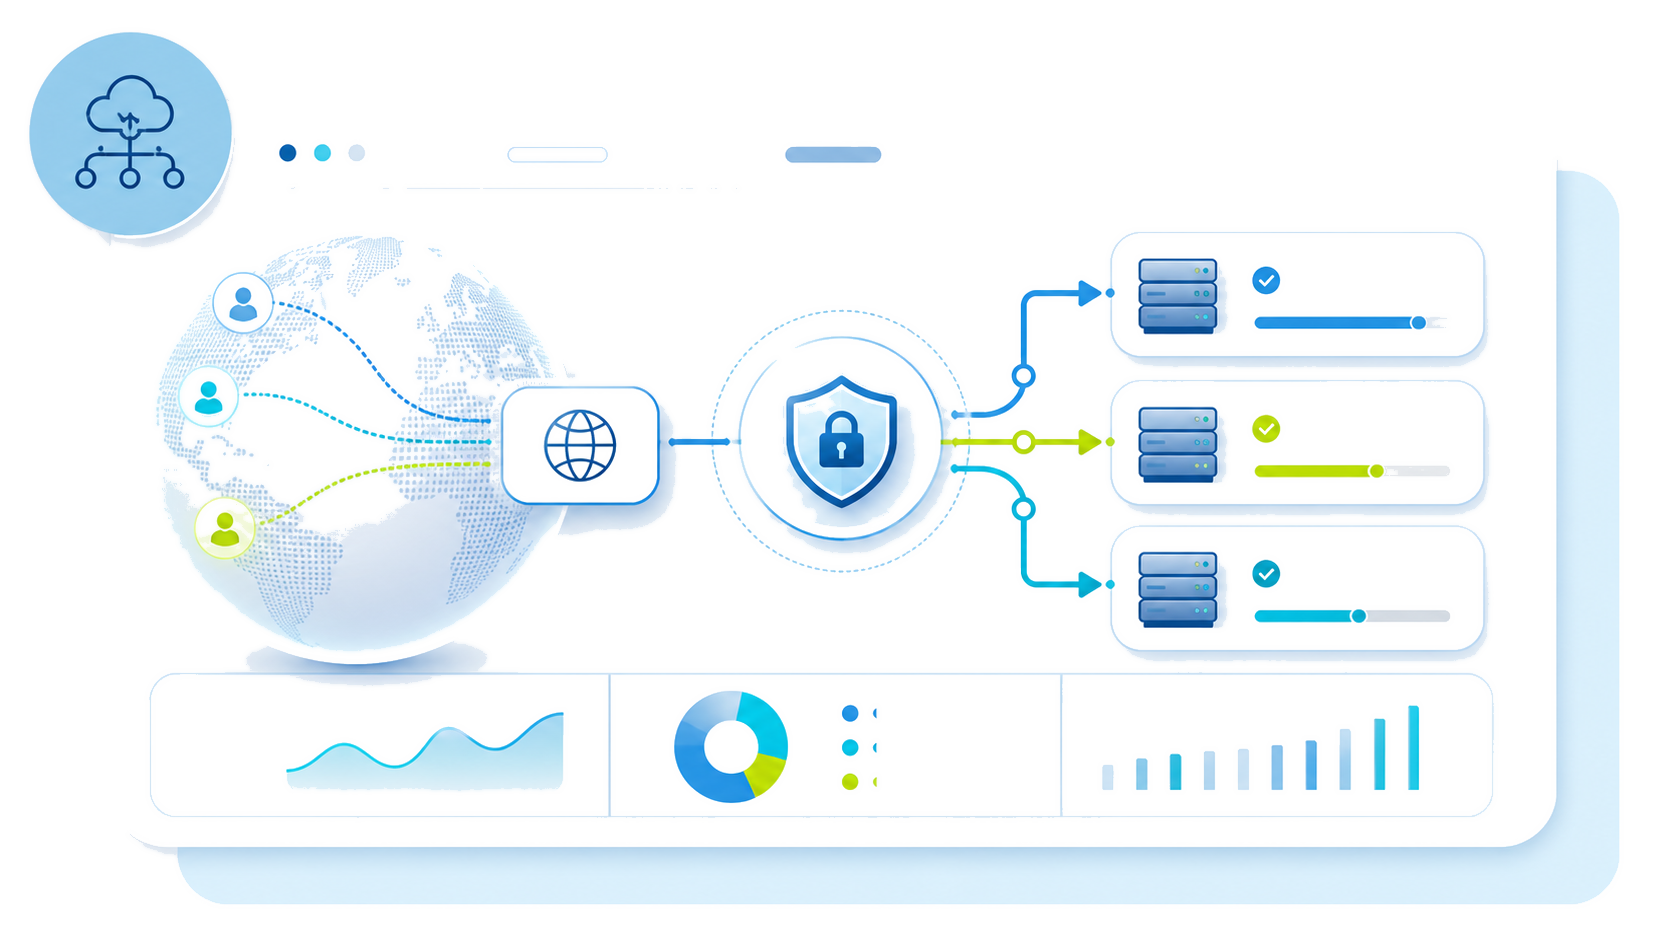
Der verwaltete Load Balancer überprüft die Integrität des Backends, terminiert TLS und verwendet gewichtetes Routing, um die Anfragenzustellung zu steuern. Wenn ein Server fehlerhaft wird, leitet ein automatisches Failover die Benutzer auf verfügbare Knoten um.

Passen Sie die Compute-Kapazität an die beobachtete Nachfrage an

Skalieren Sie eine Flotte identischer Gen3 Compute Instances hinter der Routing-Ebene. Wählen Sie die Kapazität basierend auf gemessenen Verkehrsmustern statt auf Annahmen und fügen Sie dann bei steigender Nachfrage kontrolliert Knoten hinzu. Wenn ein Unternehmen geografische Ausfallsicherheit benötigt, stellen Sie diese über drei Verfügbarkeitszonen in Paris oder Mailand bereit.

Schützen Sie die Datenbank vor verlagerten Lasten

Zusätzliche Front-End-Kapazität kann einen Datenbankengpass aufdecken, anstatt ihn zu beheben. Schützen Sie Verbindungspools, speichern Sie geeignete Zugriffsdaten im Arbeitsspeicher zwischen und überprüfen Sie langsame Such- oder Checkout-Abfragen, bevor Sie weiter skalieren. Diese Prüfungen identifizieren potenzielle Engpässe, die durch zusätzliche Anwendungsknoten nicht beseitigt werden können. DDoS-Schutz begegnet feindlichem Web-Traffic, während diese geschichtete Architektur legitime Spitzen bewältigt.

Behalten Sie bei jeder Änderung eine stabile Serviceadresse bei

OpenStack OctaviaFloating IPTLS
OpenStack Octavia leitet Anfragen an fehlerfreie Backends weiter, terminiert TLS und verwendet eine gewichtete Verteilung, um zu verhindern, dass eine VM zum Engpass am Eingangspunkt wird. Eine Floating IP bewahrt die öffentliche Adresse, während Teams Ressourcen innerhalb des erforderlichen Zeitrahmens ersetzen, in der Größe anpassen oder ein Failover durchführen.

Wählen Sie Optionen basierend auf Traffic-Messungen aus und testen Sie dann die Leistung unter Bedingungen von Flash-Sales und Medienereignissen. Diese Strategien helfen, Traffic-Spitzen ohne Ausfallzeiten zu bewältigen und schützen das Nutzererlebnis während des gesamten Skalierungsfensters.
[object Object]
Ein bekanntes Startdatum gibt Teams Zeit, die vollständige Konfiguration unter repräsentativer hoher Nachfrage zu testen. Erstellen Sie temporäre Compute-Instanzen aus einem wiederverwendbaren Golden Image, validieren Sie Customer Journeys und nutzen Sie gewichtetes Load Balancing, um Kapazitäten einzuführen, bevor Besucher eintreffen. Diese Strategie ist effektiv für saisonalen Handel, Ticketveröffentlichungen und geplante Medienberichterstattung. Da die zusätzliche Infrastruktur temporär ist, vermeidet das Unternehmen die Kosten für ungenutzte statische Kapazitäten in ruhigeren Zeiten.

Plötzliche Aufmerksamkeit erfordert eine schnelle, abgewogene Reaktion. Skalieren Sie Compute-Instanzen bei Bedarf, validieren Sie jeden neuen Knoten und verteilen Sie eingehenden Traffic auf mehrere fehlerfreie Server. Wenden Sie Ratenbegrenzung an, wenn eine knappe nachgelagerte Ressource, wie Authentifizierung, Inventar oder Zahlungsabwicklung, geschützt werden muss. Erweitern Sie nicht jede Abhängigkeit automatisch: Lesen Sie Latenz- und Fehlerindikatoren, um festzustellen, wo der Engpass liegt.

Hochverfügbarkeits-Hosting erfordert Schutz sowohl vor Nachfrageschwankungen als auch vor Standortausfällen. Eine Multi-AZ-Architektur verringert die Abhängigkeit von einer einzelnen Availability Zone, während statische Kapazität sofortigen Spielraum für übliche Schwankungen bietet. Teams können dann schnell Ressourcen hinzufügen, wenn die Bedingungen diese Basislinie überschreiten. Nachdem sich der Datenverkehr normalisiert hat, bestätigen Sie, dass Warteschlangen, Latenz und Fehler stabil bleiben, bevor Sie temporäre Knoten entfernen.
Ein bekanntes Startdatum gibt Teams Zeit, die vollständige Konfiguration unter repräsentativer hoher Nachfrage zu testen. Erstellen Sie temporäre Compute-Instanzen aus einem wiederverwendbaren Golden Image, validieren Sie Customer Journeys und nutzen Sie gewichtetes Load Balancing, um Kapazitäten einzuführen, bevor Besucher eintreffen. Diese Strategie ist effektiv für saisonalen Handel, Ticketveröffentlichungen und geplante Medienberichterstattung. Da die zusätzliche Infrastruktur temporär ist, vermeidet das Unternehmen die Kosten für ungenutzte statische Kapazitäten in ruhigeren Zeiten.

Gestalten Sie jede Reaktion auf einen Anstieg wiederholbar

Kapazitätsbasislinie

Führen Sie Lasttests für wichtige Benutzerpfade durch und zeichnen Sie auf, wo die Leistung von Rechenleistung, Netzwerk oder Datenbank überlastet wird. Diese Basislinie unterstützt einen realistischen Plan basierend auf der aktuellen Nachfrage.

Wiederverwendbarer Build

Pflegen Sie einen getesteten Instanz-Snapshot oder ein Golden Image. Jeder neue Knoten kann dann dieselbe Anwendungs-, Sicherheits- und Netzwerkkonfiguration teilen.

Operative Transparenz

Implementieren Sie vor einem Ereignis ein Monitoring für Anforderungsvolumen, Latenz, Fehler, CPU, Verbindungen und häufig abgerufene Daten. Warnmeldungen helfen Teams, schneller auf unerwartete Nachfrage zu reagieren.

Skalierungsreife

Nutzen Sie skriptgesteuerte VM-Erweiterung, um Verkehrsspitzen oder einen durch soziale Medien ausgelösten Anstieg zu bewältigen.

Führen Sie den Schutz vor Anstiegen über vier Arbeitsströme ein

Basislinie und Schutz

Quantifizieren Sie erwarteten und plötzlichen Datenverkehr, definieren Sie Serviceziele und führen Sie Lasttests für kritische Pfade durch. Stellen Sie sicher, dass die Angriffsabwehr aktiv ist, damit Teams eine erhöhte Nachfrage bewältigen können, ohne feindselige Aktivitäten mit legitimen Wachstum zu verwechseln.

Erstellen und automatisieren

Beschreiben Sie die Flotten-, Netzwerk- und Balancing-Konfiguration mit Terraform. Wiederholbarer Infrastrukturcode hilft Ingenieuren dabei, Kapazitäten konsistent innerhalb von Minuten oder Stunden hinzuzufügen, anstatt Server während eines Vorfalls manuell neu aufzubauen.

Daten und Erfahrung validieren

Testen Sie Datenbankverbindungen, Fehlerraten und Ladezeiten bei erhöhtem Datenverkehr. Beziehen Sie Knoten- und Zonenausfälle ein, um zu bestätigen, dass die Architektur ein reibungsloses Benutzererlebnis aufrechterhält, wenn einzelne Komponenten nicht verfügbar sind.

Betreiben und wiederherstellen

Dokumentieren Sie Skalierungsauslöser, Genehmigungs- und Kontaktwege, Rollback-Anleitungen und Zuständigkeiten. Definieren Sie, wann temporäre Kapazität nach einem viralen Moment sicher entfernt werden kann, basierend auf einem stabilen Servicezustand und nicht auf dem ersten Rückgang des Datenverkehrs.

Temporäre Kapazität entfernen, wenn sich die Leistung stabilisiert
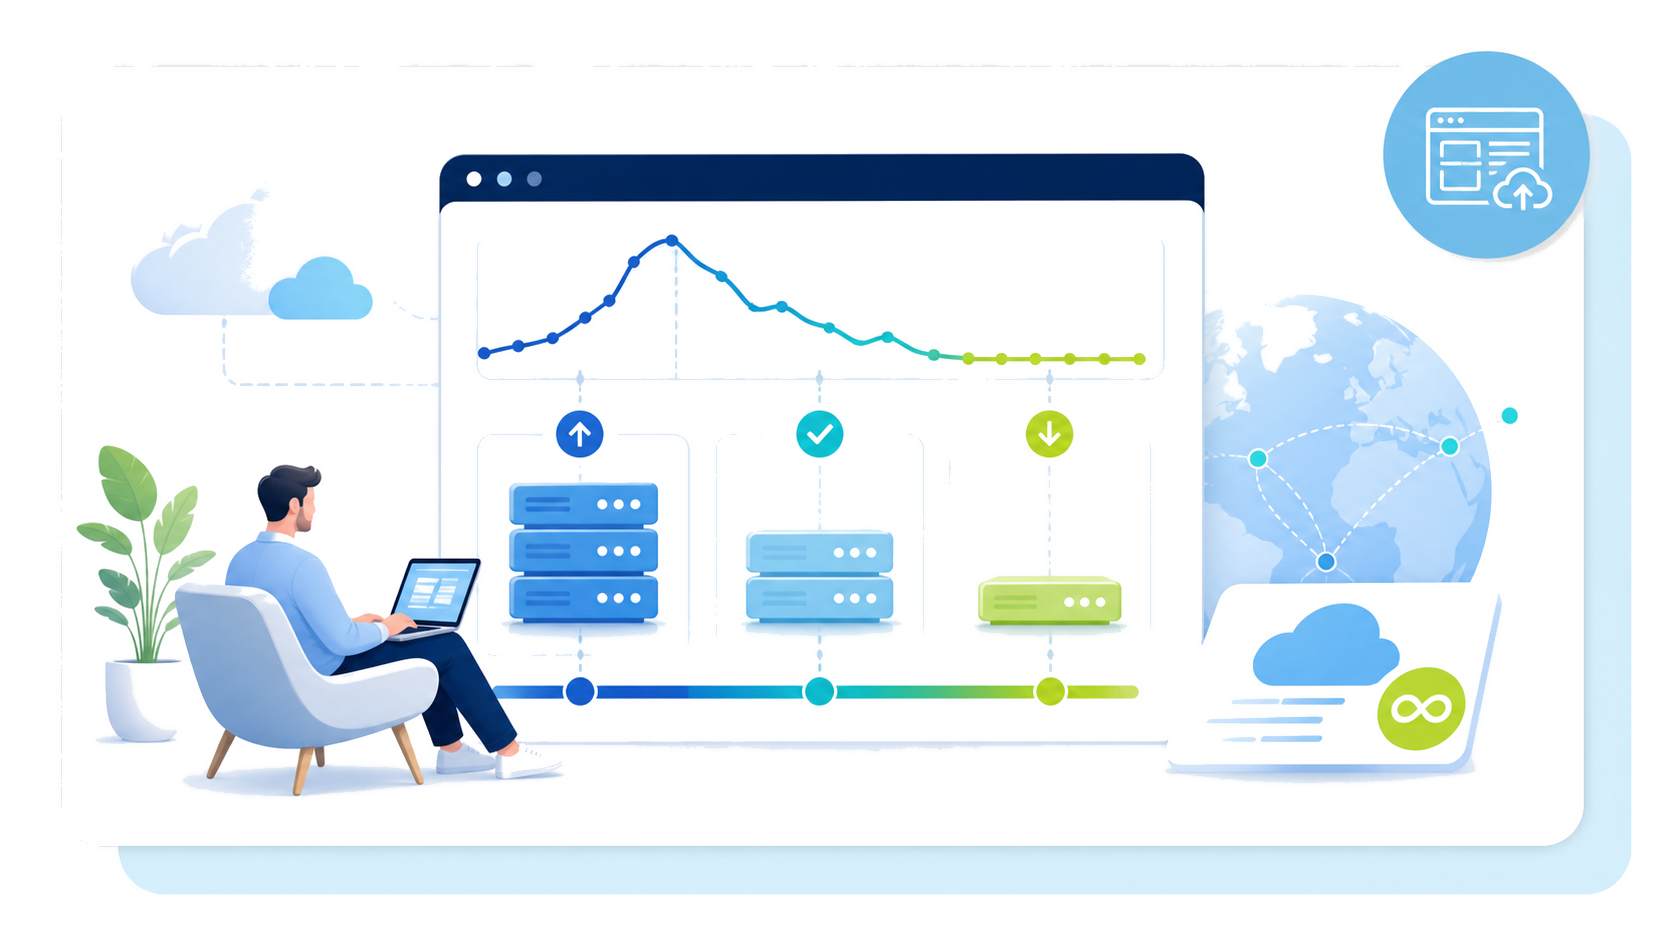
Die sekundengenaue Abrechnung für Compute-Instanzen, mit einem Minimum von 60 Sekunden ab Mai 2026, stimmt die temporäre Kapazität auf jede Spitze ab. Beobachten Sie, wann die Anwendungsnachfrage auf das Normalmaß zurückkehrt, die Anforderungswarteschlange geleert ist und sich die Servicegeschwindigkeit stabilisiert, bevor Sie überschüssige Knoten effizient entfernen. Dieser maßvolle Ansatz trägt dazu bei, die Kostenkontrolle zu gewährleisten, ohne Abstürze zu riskieren. Unbegrenzter, nicht gemessener Datenausgang in den meisten Regionen kann unnötige Unsicherheit für inhaltsreiches Cloud-Hosting reduzieren; überprüfen Sie die regionale Verfügbarkeit und die Bedingungen für Ihr Unternehmen.
[object Object]
Bereiten Sie Ihre Infrastruktur vor dem nächsten Anstieg vor
Starten Sie eine Public-Cloud-Testversion oder aktivieren Sie einen verwalteten Load Balancer. Stellen Sie Ihre Reaktion bereit, testen und verfeinern Sie sie, bevor die Nachfrage steigt.
Load Balancer aktivieren