Infra as a Service

Gestisci i picchi di traffico senza tempi di inattività e scala in pochi minuti
Mantieni i tuoi servizi online durante i picchi pianificati e la crescita imprevista. Posiziona un Load Balancer gestito davanti a un parco di Compute Instance on-demand, quindi espandi la capacità senza dover prima riprogettare la tua applicazione. 
Illustrazione nomi di dominio

Distingui la domanda autentica dagli attacchi prima di scalare
Leggi la storia dietro ogni improvviso picco di traffico. Il tasso di richieste, la CPU, la latenza e la forma del traffico forniscono la profondità tecnica necessaria per rilevare utenti reali, guasti o attività ostili. Per gestire i picchi di traffico senza tempi di inattività, distribuisci il traffico in entrata, aggiungi capacità, utilizza la memorizzazione nella cache e applica l'ottimizzazione del database. La protezione anti-DDoS affronta i flussi dannosi. Questa comprensione aiuta a gestire i picchi di traffico, prevenire i tempi di inattività del sito web in caso di traffico elevato ed evitare arresti anomali o un inutile arresto dovuto a un ridimensionamento inappropriato.
[object Object]

Salvaguardie misurabili per i picchi di traffico

Ottieni il 99,99% di SLA per Compute e Load Balancing, oltre alla protezione Anti-DDoS fino a 10 Tbps
Impegno di servizio SLA al 99,99%
Impegno di servizio al 99,99%
Protezione di mitigazione anti-DDoS
Mitigazione inclusa
Limiti di capacità di carico
Limiti di carico pubblicati

Costruisci resilienza tra routing, compute e dati

Mantieni le richieste in movimento al punto di ingresso

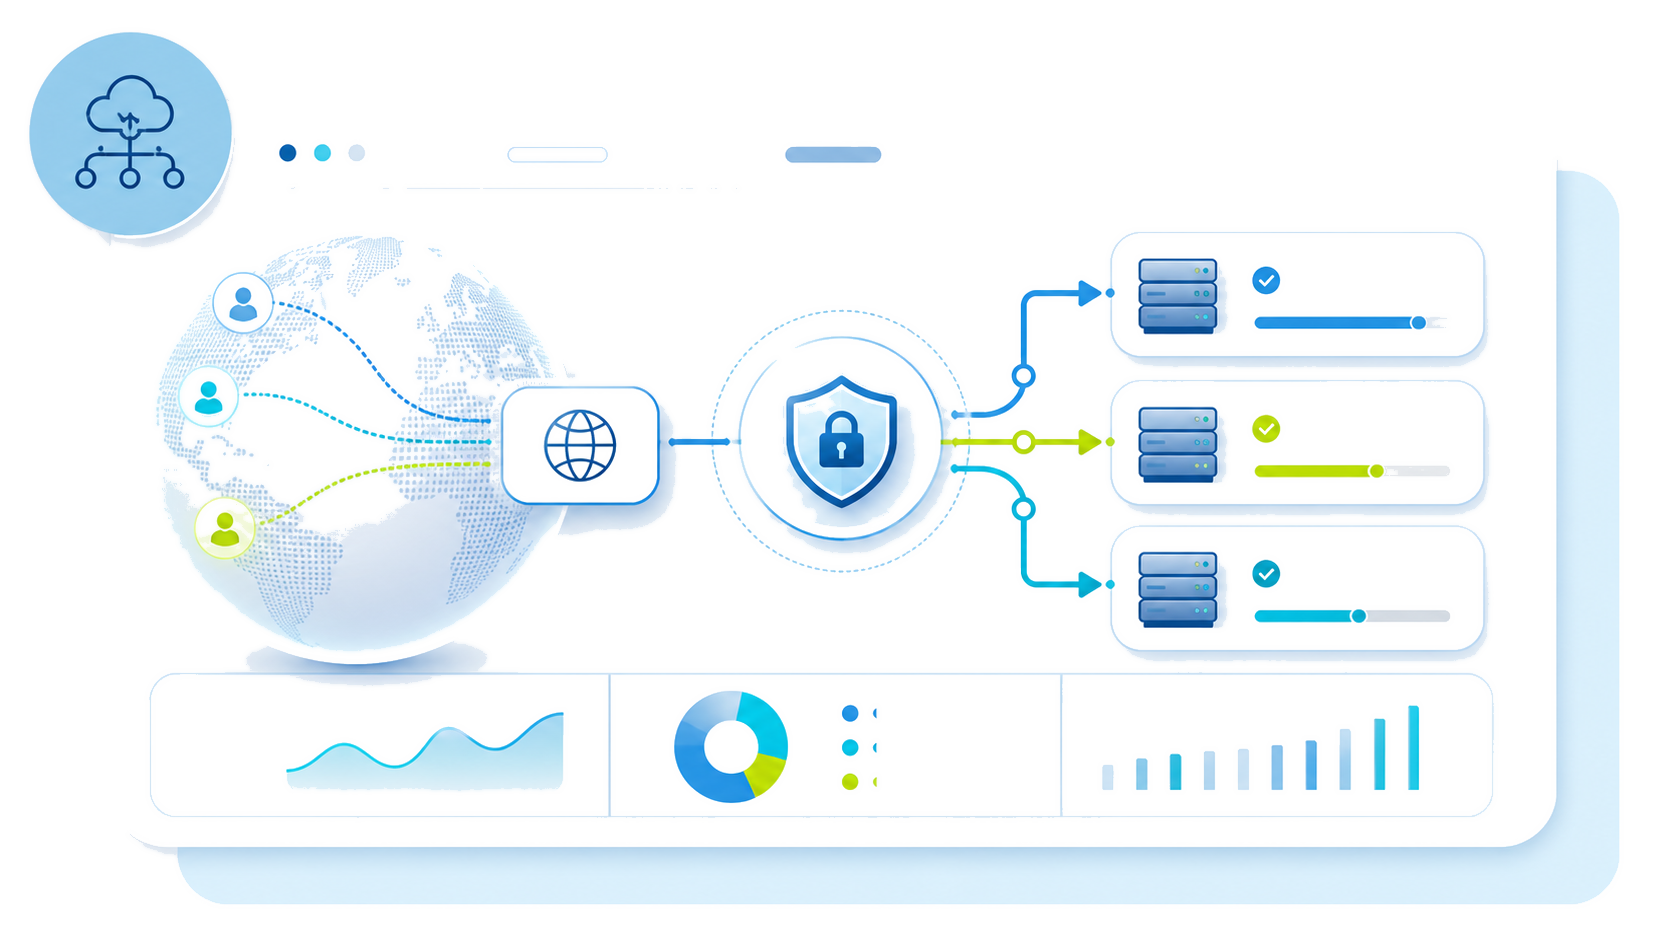
Il Load Balancer gestito controlla l'integrità del backend, termina il TLS e utilizza il routing ponderato per controllare la consegna delle richieste. Se un server diventa non integro, il failover automatico reindirizza gli utenti ai nodi disponibili.

Adatta la capacità di calcolo alla domanda osservata

Scala un parco di istanze Gen3 Compute identiche dietro il livello di routing. Scegli la capacità in base ai pattern di traffico misurati anziché alle ipotesi, quindi aggiungi nodi in un passaggio controllato man mano che la domanda cresce. Laddove un'azienda richieda resilienza geografica, esegui il deployment su tre zone di disponibilità a Parigi o Milano.

Proteggi il database dal carico spostato

Una capacità front-end aggiuntiva può esporre un vincolo del database invece di risolverlo. Proteggi i pool di connessione, memorizza nella cache i dati acceduti idonei e ispeziona le query di ricerca o di checkout lente prima di procedere con un ulteriore scaling. Questi controlli identificano potenziali colli di bottiglia che nodi applicativi aggiuntivi non possono rimuovere. La protezione DDoS gestisce il traffico web ostile, mentre questa architettura a livelli gestisce i picchi legittimi.

Mantieni un indirizzo di servizio stabile attraverso ogni modifica

OpenStack OctaviaIP mobileTLS
OpenStack Octavia instrada le richieste verso backend sani, termina TLS e utilizza una distribuzione ponderata per evitare che una VM diventi il vincolo del punto di ingresso. Un IP mobile preserva l'indirizzo pubblico mentre i team sostituiscono, ridimensionano o eseguono il failover delle risorse entro il lasso di tempo richiesto.

Seleziona le opzioni in base alle misurazioni del traffico, quindi testa le prestazioni in condizioni di flash-sale ed eventi mediatici. Queste strategie aiutano a gestire i picchi di traffico senza tempi di inattività e proteggono l'esperienza utente durante la finestra di scalabilità.
[object Object]
Una data di lancio nota offre ai team il tempo di testare la configurazione completa sotto una domanda elevata rappresentativa. Crea istanze di calcolo temporanee da un'immagine golden riutilizzabile, convalida i percorsi dei clienti e utilizza il bilanciamento del carico ponderato per introdurre capacità prima dell'arrivo dei visitatori. Questa strategia è efficace per il commercio stagionale, il rilascio di biglietti e la copertura mediatica programmata. Poiché l'infrastruttura aggiuntiva è temporanea, l'azienda evita di pagare per una capacità statica inutilizzata durante i periodi più tranquilli.

Un'attenzione improvvisa richiede una risposta rapida e misurata. Scala le istanze di calcolo su richiesta, convalida ogni nuovo nodo e distribuisci il traffico in entrata su più server sani. Applica la limitazione della velocità laddove una risorsa a valle scarsa, come l'autenticazione, l'inventario o l'elaborazione dei pagamenti, necessita di protezione. Non espandere automaticamente ogni dipendenza: leggi la latenza e gli indicatori di errore per determinare dove si trova il vincolo.

L'hosting ad alta disponibilità richiede protezione sia dai cambiamenti della domanda che dai guasti di localizzazione. Un'architettura Multi-AZ riduce la dipendenza da una singola zona di disponibilità, mentre la capacità statica fornisce un margine immediato per le fluttuazioni comuni. I team possono quindi aggiungere risorse rapidamente quando le condizioni superano tale base. Dopo che il traffico si è normalizzato, confermate che le code, la latenza e gli errori rimangano stabili prima di rimuovere i nodi temporanei.
Una data di lancio nota offre ai team il tempo di testare la configurazione completa sotto una domanda elevata rappresentativa. Crea istanze di calcolo temporanee da un'immagine golden riutilizzabile, convalida i percorsi dei clienti e utilizza il bilanciamento del carico ponderato per introdurre capacità prima dell'arrivo dei visitatori. Questa strategia è efficace per il commercio stagionale, il rilascio di biglietti e la copertura mediatica programmata. Poiché l'infrastruttura aggiuntiva è temporanea, l'azienda evita di pagare per una capacità statica inutilizzata durante i periodi più tranquilli.

Rendete ogni risposta all'aumento ripetibile

Base di capacità

Eseguite test di carico sui principali percorsi utente e registrate dove le prestazioni di calcolo, rete o database diventano sovraccariche. Questa base supporta un piano realistico basato sulla domanda attuale.

Build riutilizzabile

Mantenete uno snapshot dell'istanza testato o un'immagine golden. Ogni nuovo nodo può quindi condividere la stessa configurazione di applicazione, sicurezza e rete.

Visibilità operativa

Implementate il monitoraggio prima di un evento per il volume di richieste, la latenza, gli errori, la CPU, le connessioni e i dati consultati frequentemente. Gli avvisi aiutano i team a rispondere più rapidamente a una domanda imprevista.

Maturità di scalabilità

Utilizzate l'espansione scriptata delle VM per gestire i picchi di traffico o un aumento guidato dai social.

Implementate la protezione contro gli aumenti attraverso quattro flussi di lavoro

Stabilite una base e proteggete

Quantificate il traffico previsto e improvviso, definite gli obiettivi di servizio ed eseguite test di carico sui percorsi critici. Confermate che la mitigazione degli attacchi sia attiva in modo che i team possano gestire l'aumento della domanda senza confondere l'attività ostile con la crescita legittima.

Costruite e automatizzate

Descrivi la configurazione di flotta, rete e bilanciamento con Terraform. Il codice dell'infrastruttura ripetibile aiuta gli ingegneri ad aggiungere capacità in modo coerente in pochi minuti o ore, invece di ricostruire i server manualmente durante un incidente.

Convalida dati ed esperienza

Testa le connessioni al database, i tassi di errore e i tempi di caricamento sotto traffico aumentato. Includi i guasti di nodi e zone per confermare che l'architettura mantenga un'esperienza utente fluida quando i singoli componenti diventano non disponibili.

Gestisci e ripristina

Documenta i trigger di scalabilità, i percorsi di approvazione e contatto, le linee guida per il rollback e la proprietà. Definisci quando è sicuro rimuovere la capacità temporanea dopo un momento virale, basandoti sulla salute stabile del servizio piuttosto che sul primo calo del traffico.

Rimuovi la capacità temporanea quando le prestazioni si stabilizzano
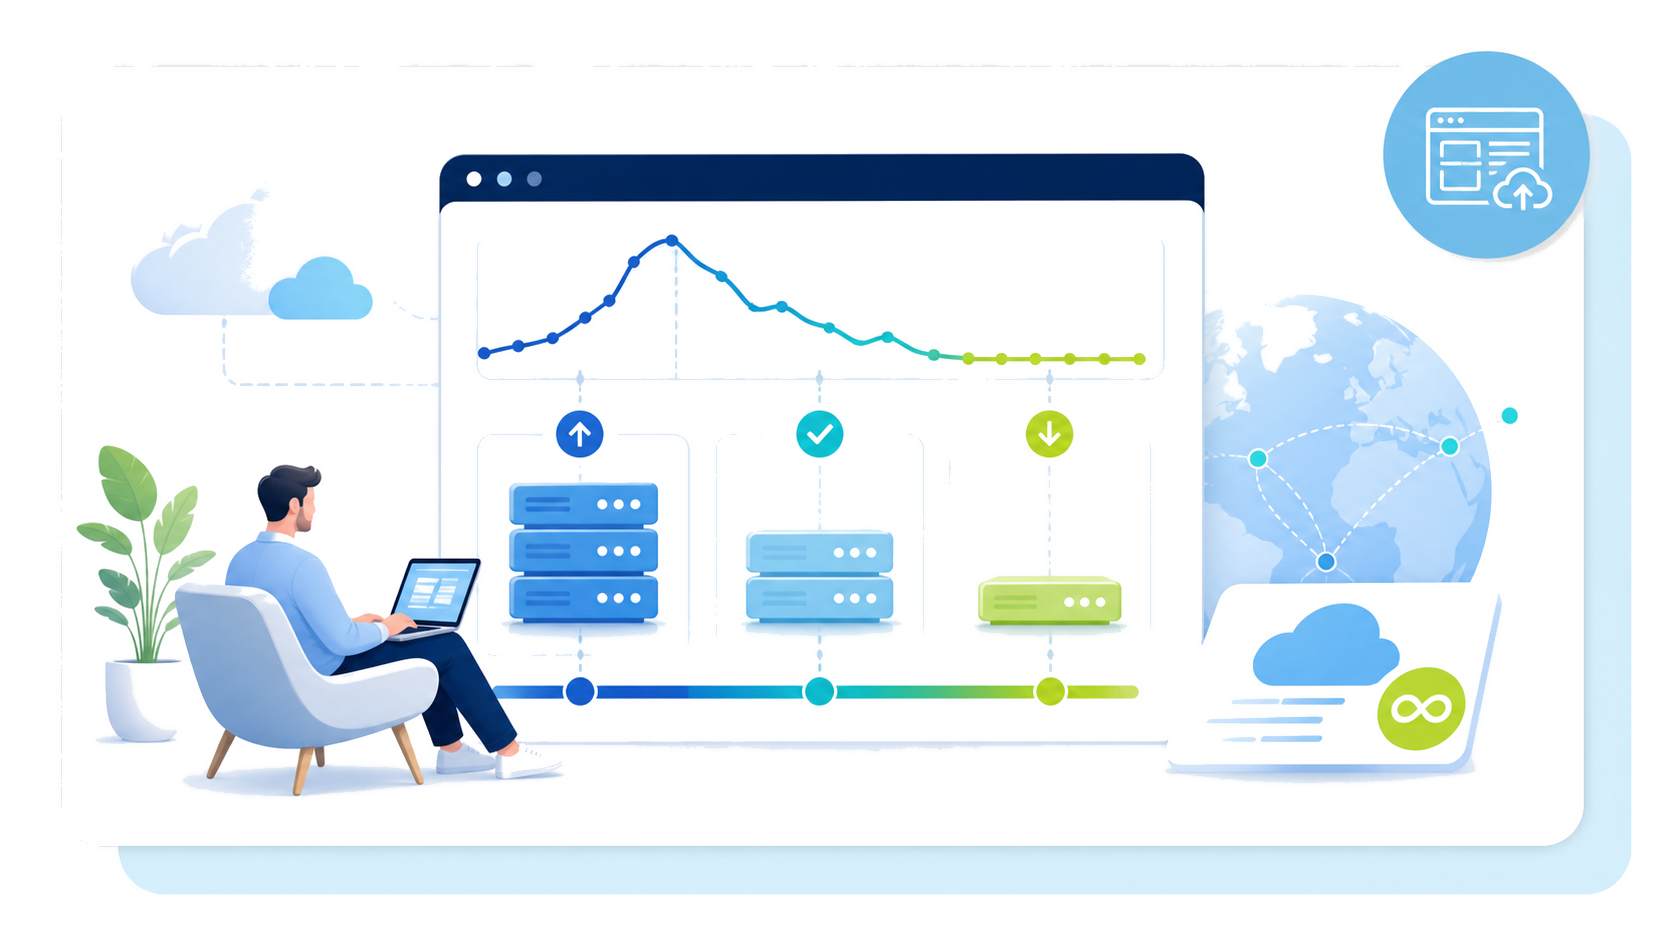
La fatturazione al secondo per le Istanze di Calcolo, con un minimo di 60 secondi da maggio 2026, allinea la capacità temporanea a ogni picco. Osserva quando la domanda dell'applicazione torna alla normalità, la coda delle richieste si svuota e la velocità del servizio si stabilizza prima di rimuovere i nodi in eccesso in modo efficiente. Questo approccio misurato aiuta a garantire il controllo dei costi senza rischiare arresti anomali. Il traffico in uscita illimitato e non misurato nella maggior parte delle regioni può ridurre l'incertezza non necessaria per l'hosting cloud ad alto contenuto; verifica la disponibilità regionale e i termini per la tua attività.
[object Object]
Prepara la tua infrastruttura prima del prossimo picco
Avvia una prova di Public Cloud o attiva un Bilanciatore di Carico gestito. Distribuisci, testa e perfeziona la tua risposta prima che la domanda aumenti.
Attiva il Bilanciatore di Carico