Bare Metal GPU ad alte prestazioni
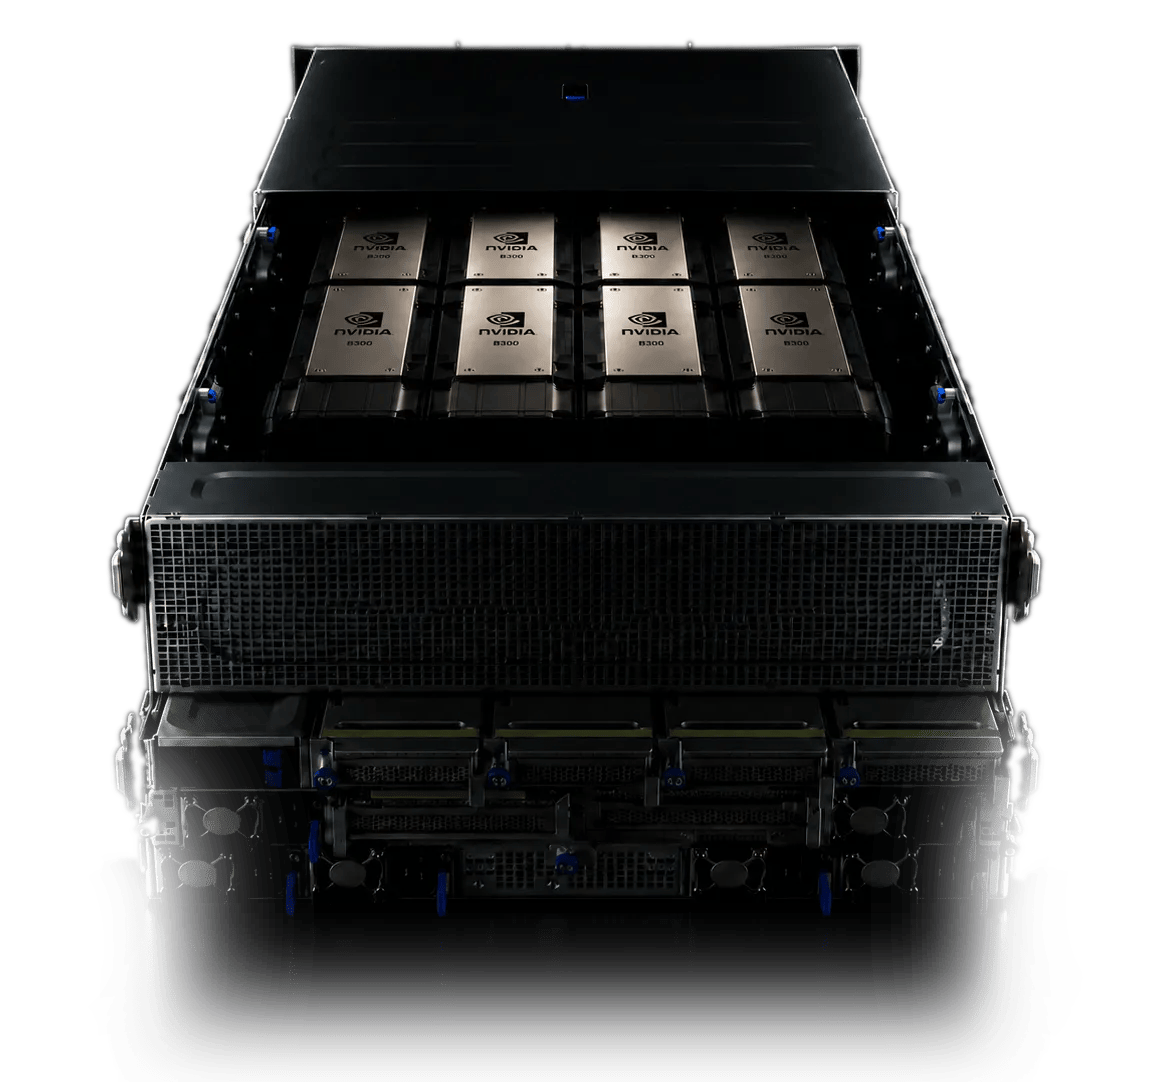
Server HGX B300 aperto, con 8 GPU NVIDIA B300
Presto disponibile

Un nodo NVIDIA HGX B300 completo, su Bare Metal

8 GPU Blackwell Ultra, 2,1 TB di HBM3e e NVLink 5, senza hypervisor né risorse condivise. Accesso root, scelta del sistema operativo e della versione del driver CUDA: controlla l'intero stack per addestrare, perfezionare e distribuire i tuoi modelli di maggiori dimensioni.

Contattaci

Impegno minimo di 12 mesi

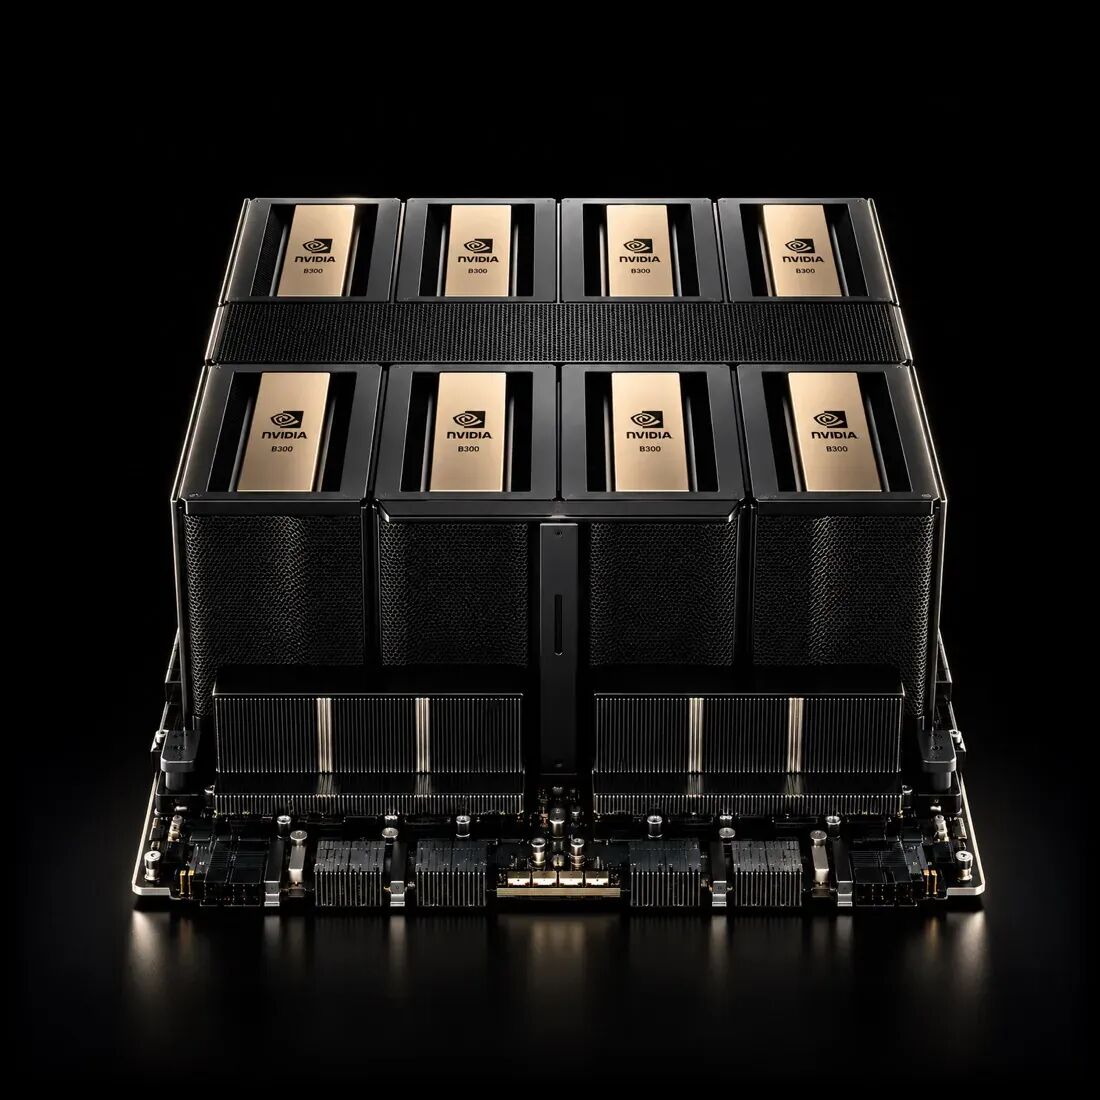
Scheda NVIDIA HGX B300 e i suoi 8 moduli GPU B300 SXM6
NVIDIA

8 GPU Blackwell Ultra: cosa cambia rispetto al B200

Rispetto a B200, B300 integra quasi il 50% in più di HBM3e, offre un calcolo denso FP4 di 1,5 volte superiore ed elabora i layer di attenzione a una velocità doppia. Un modello da mille miliardi di parametri in formato FP8 può così essere eseguito in un singolo nodo, lasciando quasi 1 TB per la cache KV. I modelli di ragionamento a contesto lungo ottengono un throughput di token superiore. Le 8 GPU costituiscono un singolo dominio NVLink 5 a 1,8 TB/s per GPU: il Tensor Parallelism e l'Expert Parallelism restano all’interno del nodo.
2,1 TBdi memoria HBM3e sul nodo
108 PFLOPSdi calcolo denso FP4 sul nodo
Benchmark

B300 a confronto con le GPU di riferimento

Scegli una GPU: ogni scheda mostra il divario rispetto alla B300.

Confronta B300 con

Calcolo IAFP8 denso, PFLOPS

B3004,5
H1001,98

Memoria GPUGB

B300262
H10080

Banda passante della memoriaTB/s

B3008
H1003,35
Per server HGR-AI-B3008 GPU B300
36 PFLOPS FP8
2,1 TB di HBM3e
64 TB/s di banda passante

Dati del produttore NVIDIA, per GPU, prestazioni massime senza sparsità. H100 e H200 in versione SXM, RTX PRO 6000 Blackwell Server Edition (FP8 denso stimato).

Scheda tecnica

HGR-AI-B300 in dettaglio

HGR-AI-B300 in dettaglio
ComponenteCaratteristicaHGR-AI-B300
GPU8× NVIDIA B300Modello8× NVIDIA HGX B300 SXM6Architettura Blackwell Ultra
Memoria GPU2,1 TB HBM3e262 GB per GPU
Banda passante della memoria64 TB/s8 TB/s per GPU
Calcolo FP4 (denso)108 PFLOPS13,5 PFLOPS per GPU
Calcolo FP8 (denso)36 PFLOPS4,5 PFLOPS per GPU
Calcolo BF16 (denso)18 PFLOPS2,25 PFLOPS per GPU
Interconnessione GPUNVLink 5ª generazione1,8 TB/s per GPU, 14,4 TB/s in totale
CPU2× Intel Xeon 6Processori2× Intel Xeon 6776PIntel Xeon 6, Granite Rapids
Core/thread128 core/256 thread2 × 64 core
Frequenza2,3 GHz/3,9 GHzBase/turbo; 3,6 GHz tutti i core, fino a 4,6 GHz con Priority Core Turbo (8 core)
Cache L3336 MB
TDP350 W per CPUSenza limitazioni termiche
RAM2 TB DDR5Capacità2 TB DDR5 ECC
Frequenza6.400 MHz
Storage38,4 TB di datiSistema3× 3,84 TB NVMe PCIe 5.0
Dati5× 7,68 TB NVMe PCIe 5.0Formato E1.S, 38,4 TB in totale
Rete e banda passanteFino a 200 Gbps privatiBanda passante pubblica10 Gbps garantiti, illimitatiOpzioni a 15, 20 o 25 Gbps
Banda passante privata100 Gbps garantiti, illimitati2 interfacce 100GbE NVIDIA ConnectX-6 Dx
Link AggregationFino a 200 Gbps privatiOVHcloud Link Aggregation sulle 2 interfacce

GPU: dati del produttore NVIDIA, prestazioni massime senza sparsità. Configurazione hardware fissa; solo la banda passante pubblica è regolabile.

Parla dell'HGR-AI-B300 con un esperto

Lascia i tuoi recapiti: il nostro team ti ricontatterà per conoscere meglio il tuo progetto.

* Campi obbligatori

I dati forniti tramite questo modulo sono trattati da OVH SAS per 36 mesi previo consenso espresso da parte dell'utente, con la finalità di proporre soluzioni relative a infrastrutture, prodotti e servizi delle entità del gruppo OVH. Per maggiori informazioni sulla protezione dei dati personali da parte di OVH SAS ed esercitare i tuoi diritti, clicca qui.

Le risposte alle tue domande

A quali utilizzi è destinato HGR-AI-B300?
HGR-AI-B300 è destinato all'addestramento e all'inferenza di modelli di grandi dimensioni, in particolare modelli di ragionamento e contesti lunghi. Le 8 GPU interconnesse e i 2 TB di memoria di sistema sono sviluppati per carichi di lavoro prolungati e intensivi. Non è invece pensato per il calcolo scientifico in doppia precisione: B300 privilegia FP4 e FP8, mentre il throughput FP64 è contenuto.
È possibile modificare la configurazione del server?
La configurazione hardware è fissa: 2 TB di DDR5, 8 GPU NVIDIA B300 e lo storage NVMe descritto precedentemente. Solo la banda passante pubblica è regolabile, da 10 Gbps (inclusi) a 25 Gbps.
In quali datacenter è disponibile HGR-AI-B300?
HGR-AI-B300 è implementato in diversi datacenter OVHcloud. Per conoscere le localizzazioni disponibili per un progetto specifico è possibile contattare il proprio referente commerciale.
Come funziona OVHcloud Link Aggregation?
OVHcloud Link Aggregation raggruppa le 2 interfacce private 100GbE del server in un unico collegamento logico. In questo modo è possibile raggiungere 200 Gbps di banda passante privata aggregata e usufruire di ridondanza in caso di malfunzionamento di un collegamento.
Quali durate contrattuali vengono proposte?
HGR-AI-B300 è proposto con un impegno minimo di 12 mesi. Online si può sottoscrivere un impegno di 12 o 24 mesi con pagamento iniziale anticipato. Contattando un commerciale OVHcloud è invece possibile impegnarsi per un periodo di 12, 24 o 36 mesi con pagamento mensile. Le spese di installazione sono gratuite.