Costruisci una pipeline di eventi in tempo reale per milioni di eventi
I due colli di bottiglia di una pipeline di eventi in tempo reale
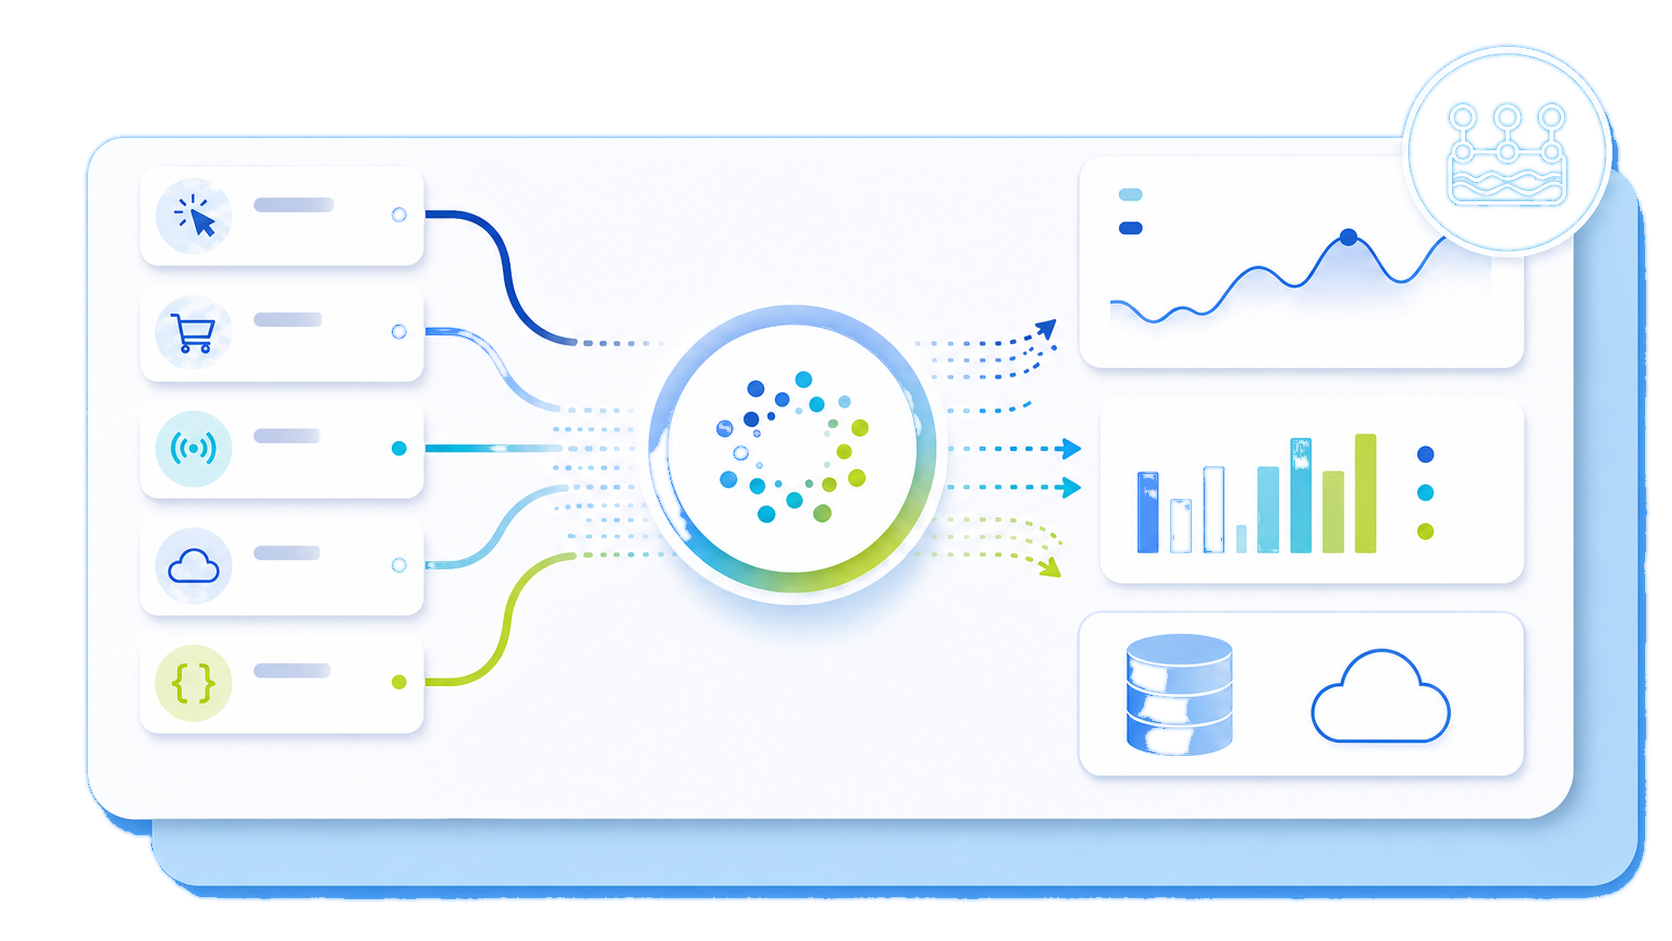
Senza una backbone di streaming durevole, i produttori e i consumatori di dati distribuiti finiscono per essere strettamente interconnessi. I produttori sono le applicazioni che generano e inviano eventi ai topic Kafka, mentre i consumatori sono i servizi che leggono quegli eventi. I produttori scrivono direttamente su code, database o servizi personalizzati e, quando un consumatore si blocca o rallenta, il produttore si blocca o inizia a perdere eventi.
Inoltre, PostgreSQL e database OLTP Public Cloud simili sono progettati per operazioni a livello di riga: inserimenti, aggiornamenti, eliminazioni. Non sono progettati per scansionare miliardi di righe, effettuare aggregazioni su più dimensioni o aggiornare dashboard ogni minuto. Man mano che il volume degli eventi cresce, le query che prima restituivano risultati in 200 ms iniziano a richiedere alcuni secondi, poi decine di secondi e infine minuti. Il sistema diventa un collo di bottiglia per le decisioni di prodotto.
Opera con sicurezza su scala enterprise

Un'architettura di riferimento: Apache Kafka + ClickHouse
Apache Kafka come backbone di streaming
Kafka funge da sistema nervoso centrale per gli eventi. I produttori scrivono eventi su topic, che sono logicamente ordinati e partizionati tra i broker. Ogni partizione può essere consumata indipendentemente, ed è così che Kafka scala la velocità orizzontalmente. I gruppi di consumer leggono da queste partizioni e ogni consumer in un gruppo è responsabile di un sottoinsieme delle partizioni.
Le partizioni sono la chiave per la velocità. Un topic con più partizioni può gestire più scritture e più consumer in parallelo, fino al numero di partizioni. I gruppi di consumer consentono il replay. Gli schemi per le applicazioni sono solitamente gestiti separatamente, spesso con uno Schema Registry, in modo che producer e consumer possano evolversi senza danneggiarsi a vicenda. Gli eventi vengono conservati per un periodo di conservazione configurabile, consentendo di rielaborare i dati senza doverli elaborare nuovamente dalla fonte. Questa durabilità e il continuo disaccoppiamento sono ciò che rende Kafka una backbone affidabile per flussi di eventi ad alto volume.
ClickHouse come livello OLAP in tempo reale
ClickHouse è un database distribuito a colonne progettato per analizzare grandi volumi di dati. Memorizza i dati per colonna anziché per riga, il che significa che può saltare le colonne irrilevanti durante le query e comprimere pesantemente i dati. Grazie al suo motore di storage, ottimizzato per le letture sequenziali e il pushdown dei predicati, ClickHouse è in grado di scansionare rapidamente miliardi di righe e restituire risultati aggregati in pochi millisecondi. I nuovi eventi possono essere ingeriti in tempo reale e ClickHouse può pre-aggregarli utilizzando viste materializzate che si aggiornano all'arrivo dei dati. Questo implica dashboard e avvisi continui, senza attendere un processo batch o una finestra ETL. Il database è progettato per scalare orizzontalmente, aggiungendo nodi per aumentare la capacità di storage e di calcolo man mano che il volume degli eventi cresce.
Object Storage come livello di dati freddi a livelli per eventi vecchi
Non tutti i dati devono necessariamente risiedere nello storage a caldo: mantenere ogni evento in ClickHouse su dischi locali diventa costoso e superfluo. Il modello comune consiste nello spostare i dati più vecchi nello storage OVHcloud Object Storage (compatibile con S3)*, mantenendo i dati recenti in ClickHouse per query veloci. Gli eventi più vecchi di una soglia configurata vengono interrogati su richiesta quando è necessaria un'analisi storica più approfondita. Questo approccio riduce il costo della conservazione a lungo termine preservando la capacità di eseguire query sull'intero set di dati.
Per molti casi d'uso di elaborazione reale, il livello a caldo (ClickHouse) conserva giorni o settimane di dati per dashboard e avvisi in tempo reale, mentre il livello a freddo (OVHcloud Object Storage) conserva mesi o anni di cronologia per conformità, audit e analisi approfondite periodiche. Questa separazione rende prevedibili i costi operativi e consente alla pipeline di scalare senza raggiungere un limite rigido di storage delle applicazioni.
L'integrazione nativa del motore Kafka in ClickHouse
ClickHouse dispone di un motore di tabella Kafka integrato che consente di iscriversi direttamente agli argomenti Kafka. Si definisce una tabella con il motore Kafka, si specificano il nome dell'argomento, l'elenco dei broker e il gruppo di consumatori, e ClickHouse inizia a consumare eventi da Kafka come se fossero righe in una tabella normale. Questa è un'integrazione diretta e nativa che non richiede middleware aggiuntivo. Il motore Kafka in ClickHouse è progettato per l'ingestione in streaming. Legge i record dall'argomento, li analizza in base al formato specificato (JSON, Avro, Protobuf, ecc.) e li presenta come righe che possono essere interrogate o inserite in altre tabelle.
Modella gli eventi in arrivo per decisioni più rapide
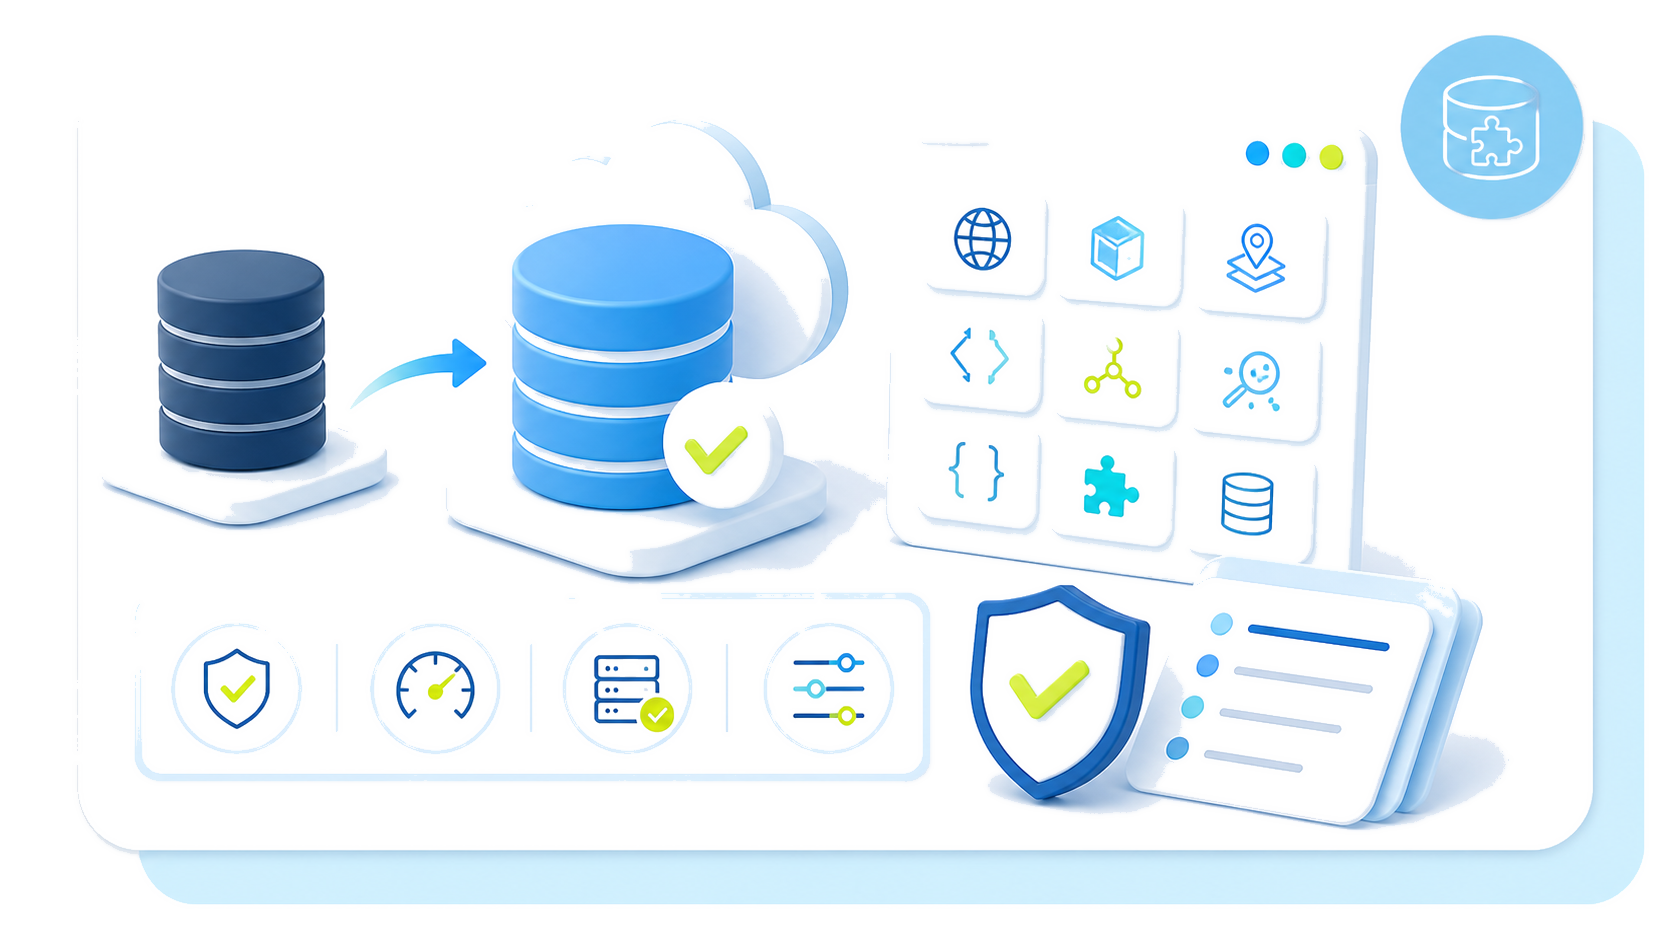
Pre-aggrega le misure ricorrenti
Le viste materializzate calcolano continuamente totali, tassi e metriche raggruppate man mano che gli eventi arrivano, riducendo il lavoro ripetuto al momento della query.
Allinea le tabelle ai modelli di accesso
Ordina i dati per tempo e dimensioni comunemente filtrate in modo che le analisi leggano meno record irrilevanti.
Leggi solo i campi utili
La selezione delle colonne limita la scansione agli attributi richiesti da ogni dashboard, avviso o query esplorativa.
Progetta la conservazione in base alla domanda
Separa i record interrogati frequentemente dai dati meno attivi. Le tabelle con conservazione consapevole contribuiscono a mantenere analisi in frazioni di secondo per le viste operative, assicurando al contempo le indagini pratiche man mano che le cronologie crescono.
Il costo dell'attesa
Assegna a ogni livello una responsabilità chiara
Backbone di streaming
Memorizza, ordina e riproduci flussi di eventi ad alto volume, in modo che i produttori rimangano indipendenti dai carichi di lavoro di elaborazione e analisi.
Rilascio di dati analitici
Rendi disponibili i dati relativi agli eventi più recenti per query operative rapide, dashboard e analisi, mantenendo al contempo un ambiente dedicato alla domanda analitica.
Livello dati freddi
Conserva lo storico più vecchio al di fuori dello storage focalizzato sulle prestazioni. Questa separazione assicura l'accessibilità a lungo termine senza mantenere ogni evento nel percorso analitico caldo. Il modello comune consiste nel suddividere i dati più vecchi in livelli in OVHcloud Object Storage
Operazioni e distribuzione gestite
OVHcloud gestisce la replica, i backup e il monitoraggio nell'intera architettura di servizio. I team possono distribuire risorse tramite lo Spazio Cliente OVHcloud o definire ambienti ripetibili con Terraform.
Implementa una pipeline di eventi in tempo reale in pochi minuti
Per i team che desiderano assistenza nel dimensionamento dello stack, OVHcloud offre accesso diretto a specialisti di infrastrutture dati, anche per Managed Databases for PostgreSQL, che possono valutare gli attuali volumi di eventi e pattern di query e fornire un confronto dei costi rispetto al tuo stack esistente. Che tu sia un Data Engineer che necessita di risultati in tempo reale su miliardi di righe con un tempo di infrastruttura minimo, o un Head of Data che desidera un carico operativo ridotto e costi cloud prevedibili, lo stack gestito elimina il sovraccarico operativo mantenendo l'architettura portabile e open source.
*S3 è un marchio registrato di Amazon Technologies, Inc. I servizi di OVHcloud non sono in alcun modo sponsorizzati, approvati o affiliati da Amazon Technologies, Inc.
Esplora i nostri servizi di streaming, analisi e Storage, quindi trasforma eventi ad alto volume in insight affidabili e interrogabili, riducendo al contempo il lavoro operativo necessario per gestire l'infrastruttura sottostante.