Infra as a Service

Obsługuj skoki ruchu bez przestojów i skaluj w kilka minut
Utrzymuj swoje usługi online podczas planowanych szczytów i nieoczekiwanego wzrostu. Umieść zarządzany Load Balancer przed flotą instancji obliczeniowych typu on-demand, a następnie zwiększ wydajność bez konieczności wcześniejszego przeprojektowywania aplikacji. 
Ilustracja nazw domen

Odróżniaj rzeczywisty popyt od ataków przed skalowaniem
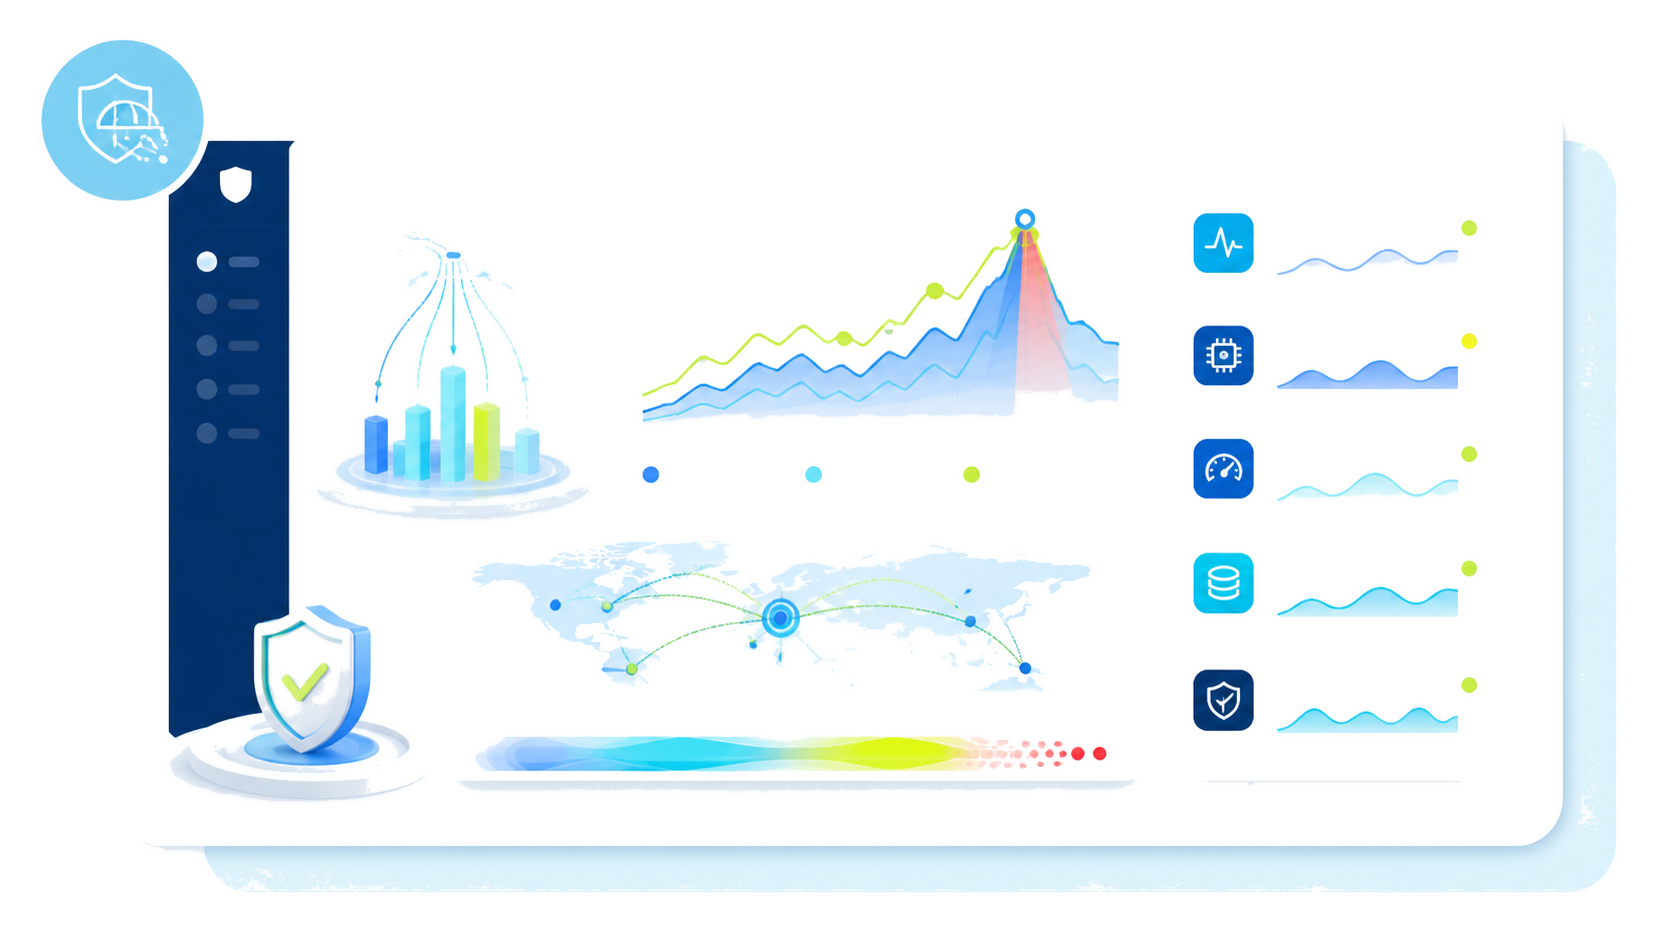
Poznaj historię każdego nagłego skoku ruchu. Wskaźnik żądań, użycie procesora, opóźnienia i kształt ruchu zapewniają głębię techniczną potrzebną do wykrycia rzeczywistych użytkowników, usterek lub wrogich działań. Aby obsłużyć skok ruchu bez przestojów, rozdzielaj ruch przychodzący, zwiększaj wydajność, korzystaj z buforowania i stosuj optymalizację bazy danych. Ochrona anty-DDoS radzi sobie ze złośliwymi przepływami. To zrozumienie pomaga zarządzać skokami ruchu, zapobiegać przestojom witryny przy dużym natężeniu ruchu oraz unikać awarii lub niepotrzebnego zawieszenia wynikającego z niewłaściwego skalowania.
[object Object]

Mierzalne zabezpieczenia na wypadek nagłych wzrostów ruchu

Uzyskaj SLA 99,99% dla obliczeń i równoważenia obciążenia oraz ochronę Anti-DDoS do 10 Tb/s
Zobowiązanie do dostępności usług SLA na poziomie 99,99%
Zobowiązanie do dostępności usług na poziomie 99,99%
Ochrona mitygacyjna anty-DDoS
Uwzględniona mitygacja
Limity wydajności obciążenia
Opublikowane limity obciążenia

Buduj odporność w zakresie routingu, obliczeń i danych

Utrzymuj płynność żądań w punkcie wejścia

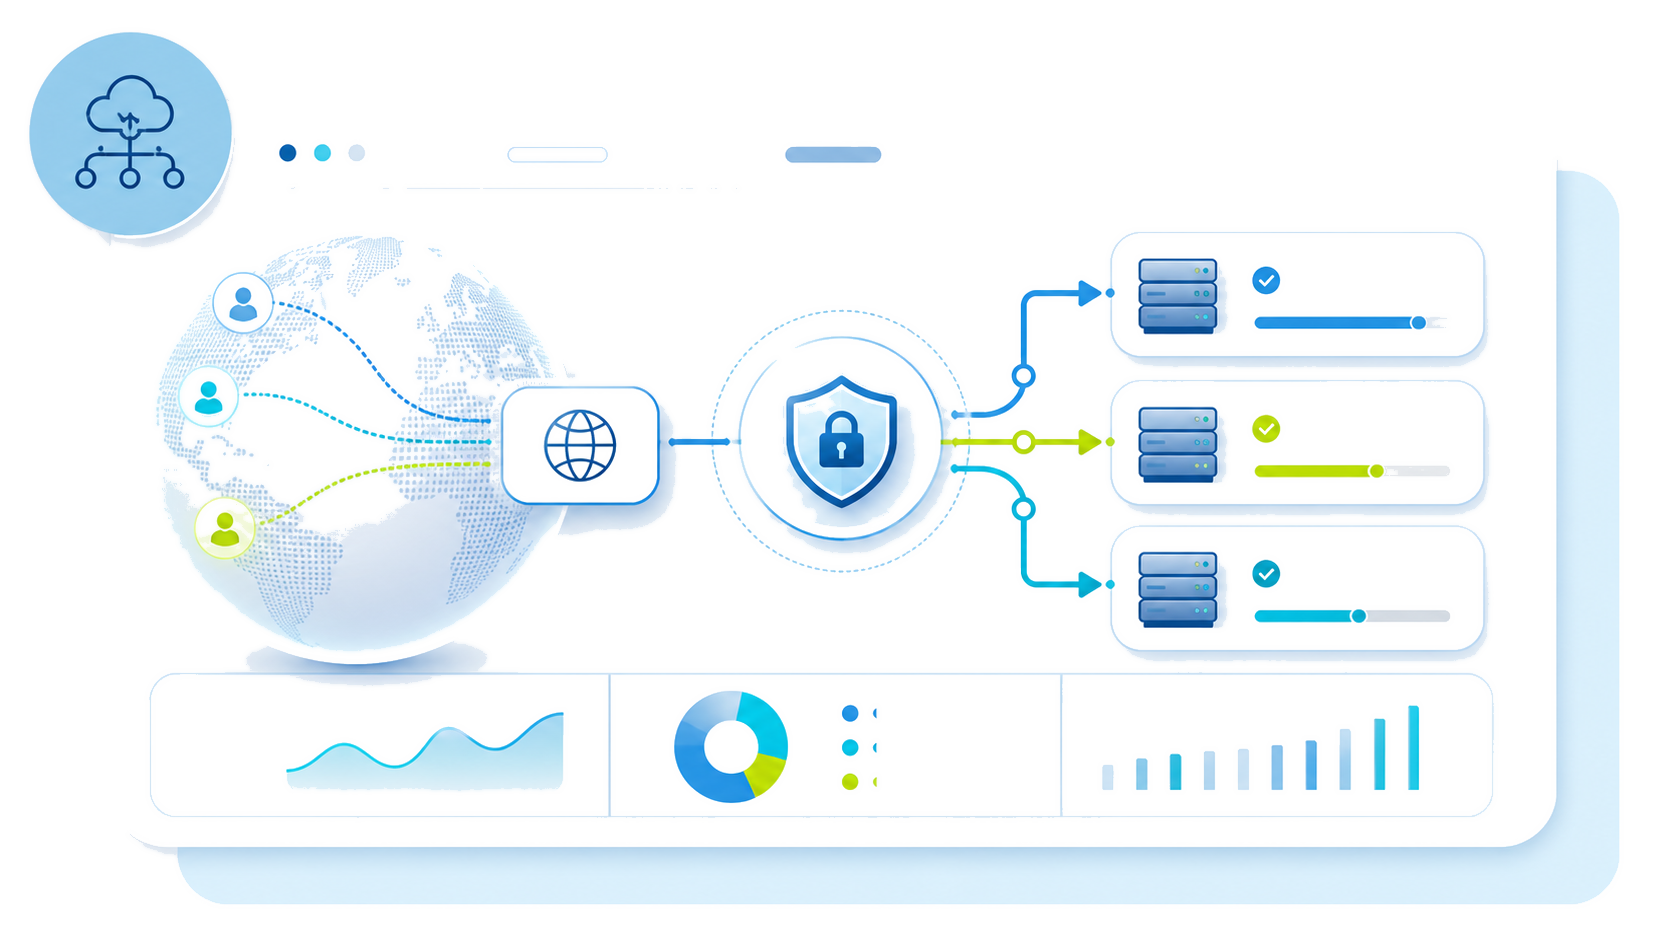
Zarządzany Load Balancer sprawdza stan backendu, kończy połączenia TLS i wykorzystuje ważony routing do kontrolowania dostarczania żądań. Jeśli serwer przestanie działać poprawnie, automatyczne przełączanie awaryjne przekieruje użytkowników do dostępnych węzłów.

Dopasuj moc obliczeniową do zaobserwowanego popytu

Skaluj flotę identycznych instancji obliczeniowych Gen3 za warstwą routingu. Wybierz wydajność na podstawie zmierzonych wzorców ruchu, a nie założeń, a następnie dodawaj węzły w kontrolowanych krokach w miarę wzrostu popytu. Jeśli firma wymaga odporności geograficznej, należy wdrożyć rozwiązanie w trzech strefach dostępności w Paryżu lub Mediolanie.

Chroń bazę danych przed przeniesionym obciążeniem

Dodatkowa wydajność front-endu może ujawnić ograniczenia bazy danych zamiast je rozwiązać. Chroń pule połączeń, buforuj odpowiednie dane w pamięci i sprawdzaj wolne zapytania wyszukiwania lub realizacji transakcji przed dalszym skalowaniem. Te kontrole identyfikują potencjalne wąskie gardła, których dodatkowe węzły aplikacji nie są w stanie usunąć. Ochrona przed atakami DDoS radzi sobie z wrogim ruchem internetowym, podczas gdy ta warstwowa architektura obsługuje uzasadnione skoki obciążenia.

Zachowaj stabilny adres usługi przy każdej zmianie

OpenStack OctaviaPływający adres IPTLS
OpenStack Octavia kieruje żądania do sprawnych backendów, kończy połączenia TLS i wykorzystuje ważoną dystrybucję, aby zapobiec sytuacji, w której jedna maszyna wirtualna staje się wąskim gardłem. Pływający adres IP (Floating IP) zachowuje publiczny adres, podczas gdy zespoły wymieniają, zmieniają rozmiar lub przełączają zasoby w wymaganym czasie.

Wybieraj opcje na podstawie pomiarów ruchu, a następnie testuj wydajność w warunkach wyprzedaży błyskawicznych i wydarzeń medialnych. Te strategie pomagają radzić sobie ze skokami ruchu bez przestojów i chronią komfort użytkownika w trakcie okna skalowania.
[object Object]
Znana data premiery daje zespołom czas na przetestowanie pełnej konfiguracji w warunkach reprezentatywnego, dużego obciążenia. Twórz tymczasowe instancje obliczeniowe z użyciem gotowego obrazu, weryfikuj ścieżki użytkowników i stosuj ważone równoważenie obciążenia, aby wprowadzić dodatkową wydajność przed przybyciem odwiedzających. Ta strategia jest skuteczna w przypadku handlu sezonowego, sprzedaży biletów i zaplanowanych wydarzeń medialnych. Ponieważ dodatkowa infrastruktura jest tymczasowa, firma unika płacenia za niewykorzystaną statyczną rezerwę w spokojniejszych okresach.

Nagłe zainteresowanie wymaga szybkiej i przemyślanej reakcji. Skaluj instancje obliczeniowe na żądanie, weryfikuj każdy nowy węzeł i rozdzielaj przychodzący ruch pomiędzy wiele sprawnych serwerów. Stosuj ograniczanie szybkości (rate limiting), gdy zasób podrzędny, taki jak uwierzytelnianie, inwentaryzacja lub przetwarzanie płatności, wymaga ochrony. Nie rozszerzaj automatycznie każdej zależności: analizuj opóźnienia i wskaźniki błędów, aby określić, gdzie występuje ograniczenie.

Hosting o wysokiej dostępności wymaga ochrony zarówno przed zmianami popytu, jak i awariami lokalizacji. Architektura Multi-AZ zmniejsza zależność od jednej strefy dostępności, podczas gdy statyczna pojemność zapewnia natychmiastowy zapas na typowe wahania. Zespoły mogą następnie szybko dodawać zasoby, gdy warunki przekroczą ten punkt odniesienia. Po unormowaniu się ruchu potwierdź, że kolejki, opóźnienia i błędy pozostają stabilne przed usunięciem tymczasowych węzłów.
Znana data premiery daje zespołom czas na przetestowanie pełnej konfiguracji w warunkach reprezentatywnego, dużego obciążenia. Twórz tymczasowe instancje obliczeniowe z użyciem gotowego obrazu, weryfikuj ścieżki użytkowników i stosuj ważone równoważenie obciążenia, aby wprowadzić dodatkową wydajność przed przybyciem odwiedzających. Ta strategia jest skuteczna w przypadku handlu sezonowego, sprzedaży biletów i zaplanowanych wydarzeń medialnych. Ponieważ dodatkowa infrastruktura jest tymczasowa, firma unika płacenia za niewykorzystaną statyczną rezerwę w spokojniejszych okresach.

Spraw, aby każda reakcja na nagły wzrost była powtarzalna

Punkt odniesienia pojemności

Przetestuj pod obciążeniem główne ścieżki użytkownika i zarejestruj, w którym momencie wydajność obliczeniowa, sieciowa lub bazodanowa staje się przeciążona. Ten punkt odniesienia wspiera realistyczny plan oparty na bieżącym zapotrzebowaniu.

Budowa wielokrotnego użytku

Utrzymuj przetestowaną migawkę instancji lub złoty obraz. Każdy nowy węzeł może wtedy współdzielić tę samą konfigurację aplikacji, zabezpieczeń i sieci.

Widoczność operacyjna

Wdróż monitorowanie przed wystąpieniem zdarzenia dla wolumenu żądań, opóźnień, błędów, użycia procesora, połączeń oraz często uzyskiwanych danych. Alerty pomagają zespołom szybciej reagować na nieoczekiwany popyt.

Dojrzałość skalowania

Użyj skryptowego rozszerzania maszyn wirtualnych, aby obsłużyć skoki ruchu lub nagły wzrost spowodowany mediami społecznościowymi.

Wdróż ochronę przed nagłym wzrostem ruchu poprzez cztery strumienie prac

Ustalenie punktu odniesienia i ochrona

Określ ilościowo oczekiwany i nagły ruch, zdefiniuj cele usługowe i przetestuj pod obciążeniem ścieżki krytyczne. Potwierdź, że mitygacja ataków jest aktywna, aby zespoły mogły obsłużyć zwiększony popyt bez mylenia wrogiej aktywności z legalnym wzrostem.

Buduj i automatyzuj

Opisz konfigurację floty, sieci i równoważenia obciążenia za pomocą Terraform. Powtarzalny kod infrastruktury pomaga inżynierom dodawać pojemność w sposób spójny w ciągu minut lub godzin, zamiast ręcznie przebudowywać serwery podczas incydentu.

Zweryfikuj dane i doświadczenie

Przetestuj połączenia z bazą danych, wskaźniki błędów i czasy ładowania przy zwiększonym ruchu. Uwzględnij awarie węzłów i stref, aby potwierdzić, że architektura utrzymuje płynne działanie dla użytkownika, gdy poszczególne komponenty stają się niedostępne.

Obsługuj i odzyskuj

Udokumentuj wyzwalacze skalowania, ścieżki zatwierdzania i kontaktu, wytyczne dotyczące wycofywania zmian oraz własność. Zdefiniuj, kiedy bezpiecznie jest usunąć tymczasową pojemność po nagłym wzroście popularności, w oparciu o stabilny stan usługi, a nie pierwszy spadek ruchu.

Usuń tymczasową pojemność, gdy wydajność się ustabilizuje
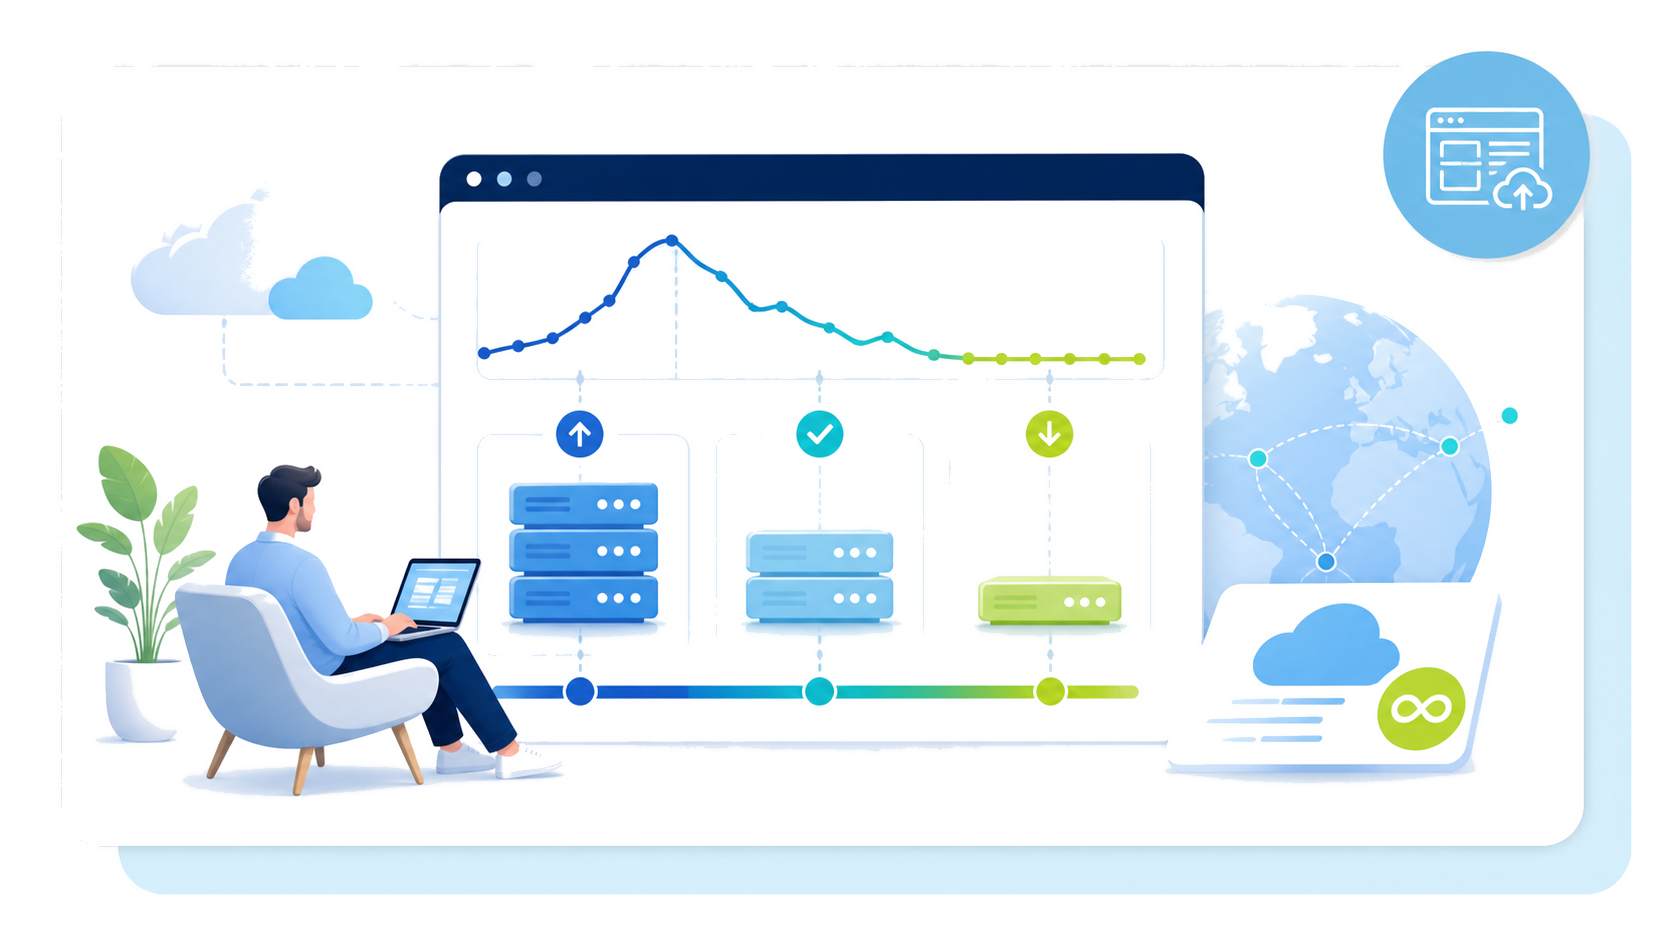
Rozliczanie sekundowe instancji obliczeniowych, z 60-sekundowym minimum od maja 2026 r., pozwala dostosować tymczasową pojemność do każdego skoku. Obserwuj, kiedy popyt na aplikację wraca do normy, kolejka żądań maleje, a szybkość usługi stabilizuje się, zanim sprawnie usuniesz nadmiarowe węzły. To wyważone podejście pomaga zapewnić kontrolę kosztów bez ryzyka awarii. Nielimitowany, niemierzony ruch wychodzący w większości regionów może zmniejszyć niepotrzebną niepewność w przypadku hostingu w chmurze z dużą ilością treści; sprawdź dostępność regionalną i warunki dla swojej firmy.
[object Object]
Przygotuj swoją infrastrukturę przed kolejnym wzrostem ruchu
Rozpocznij okres próbny Public Cloud lub aktywuj zarządzany Load Balancer. Wdróż, przetestuj i udoskonal swoją reakcję, zanim wzrośnie popyt.
Aktywuj Load Balancer