AI Deploy
Udostępniaj model AI przez API, korzystając z własnego kontenera i dedykowanych procesorów GPU. Autoskalowanie na podstawie własnych metryk, aż do zera replik. Rozliczanie za każdą minutę działania.
Udostępniaj modele bez zarządzania infrastrukturą

Bez konieczności zarządzania serwerami
OVHcloud zarządza serwerami, endpointami, autoskalowaniem i Grafaną. Ty zarządzasz obrazami i modelami.
Szybkie uruchomienie
Sterowniki i CUDA są już przygotowane. Podczas uruchamiania ładowane są tylko obraz i model.
Autoskalowanie dopasowane do potrzeb
Skaluj usługę na podstawie własnej metryki. Gdy nie ma ruchu, aplikacja się zatrzymuje, a opłaty przestają być naliczane. Grafana w cenie.
Zgodność z przepisami i bezpieczeństwo
ISO 27001, SOC 2 Type II, HDS (regiony UE). Poszanowanie suwerenności danych.
Uruchom model w środowisku produkcyjnym w 3 krokach
1. Wybierz obraz
Wdróż serwer inferencyjny, API lub aplikację.
2. Skonfiguruj GPU i skalowanie
Wybierz GPU, a następnie skonfiguruj autoskalowanie na podstawie własnej metryki – nawet do zera replik.
3. Wywołaj endpoint
Adres URL HTTPS zabezpieczony tokenem albo loginem i hasłem.
Wdróż serwer inferencyjny, API lub aplikację.
2. Skonfiguruj GPU i skalowanie
Wybierz GPU, a następnie skonfiguruj autoskalowanie na podstawie własnej metryki – nawet do zera replik.
3. Wywołaj endpoint
Adres URL HTTPS zabezpieczony tokenem albo loginem i hasłem.
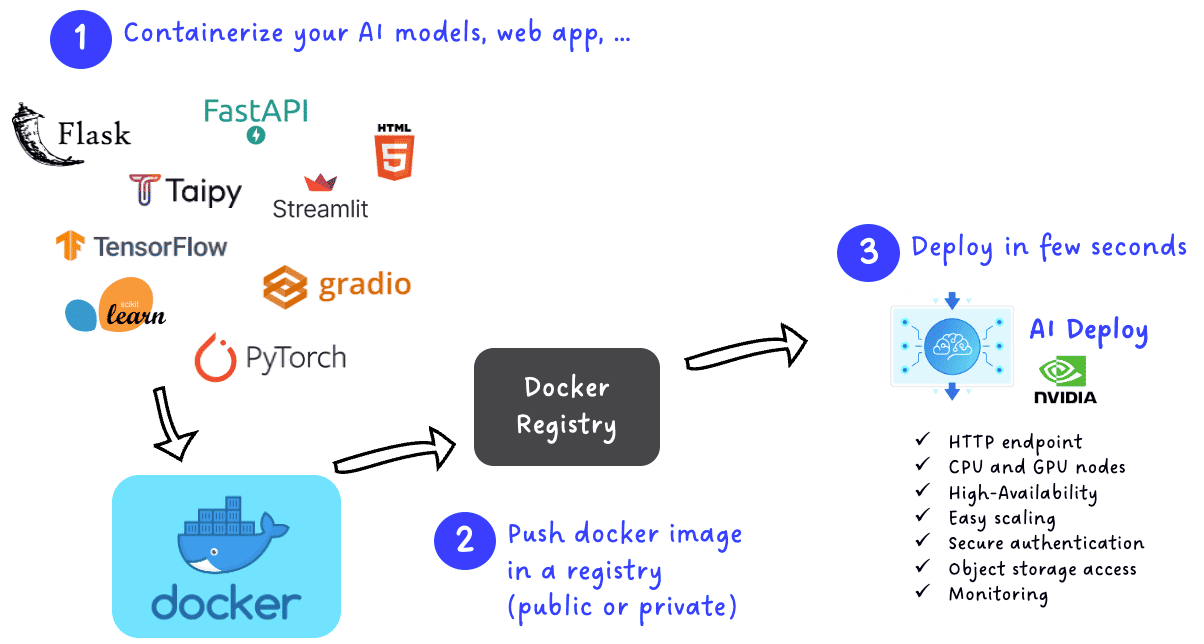
Wszystko, czego potrzebujesz, aby udostępniać model w środowisku produkcyjnym

Reguły autoskalowania
CPU, RAM lub własna metryka. Możliwość ustawienia czasu, po którym liczba replik zostanie zmniejszona do zera.
Wysoka dostępność
Równoważenie obciążenia zarządzane przez OVHcloud i automatyczne odtwarzanie replik.
Aktualizacje bez przestojów
Nowy obraz jest wdrażany pod tym samym adresem URL, bez przerwy w działaniu usługi.
Monitorowanie w Grafanie
Metryki CPU, GPU i RAM dla każdej aplikacji – bez konieczności konfiguracji.
Bezpieczny dostęp
Endpoint zabezpieczony tokenem lub hasłem.Wolumeny Object Storage
Wagi modelu są ładowane z zasobnika, a nie z obrazu.Konsola, API lub CLI
Z poziomu Panelu klienta albo za pomocą API, CLI lub SDK Python.Obrazy z rejestru
Obrazy z Docker Hub, GitHub lub Managed Private Registry.
Przykłady zastosowań
Trzy sposoby udostępniania modeli w AI Deploy – każdy z przewodnikiem, który ułatwi rozpoczęcie pracy.

Twój dostrojony model LLM
Dostosowałeś model z otwartymi wagami do potrzeb swojej branży? Udostępnij go za pomocą vLLM, aby można było wywoływać go z dowolnego narzędzia zgodnego z OpenAI.
Chatboty RAG i agenci
Twój asystent odpowiada na podstawie Twoich dokumentów. Aplikacja działa w AI Deploy, wektory są przechowywane w pgvector, a model LLM działa w AI Endpoints.
Narzędzia wewnętrzne i wersje demonstracyjne
Prototypy, wersje demonstracyjne i aplikacje Streamlit dla Twoich zespołów. Możesz korzystać z nich przez kilka godzin dziennie, a przez resztę czasu je wyłączać.
AI Deploy – historie wdrożeń
- Przeczytaj case study
lector.ai
500 mln przetworzonych stron · o 80% krótszy czas przetwarzania. Przetwarzanie dokumentów dla firm z sektora ubezpieczeń zdrowotnych po migracji z chmury amerykańskiego dostawcy. - Przeczytaj case study
moinAI
Chatboty obsługi klienta: moinAI trenuje modele w AI Training, a następnie udostępnia je w AI Deploy.
AI Deploy czy Cloud GPU?
Zastanawiasz się, czy do udostępniania modeli wybrać AI Deploy, czy własne instancje Cloud GPU? Oto najważniejsze różnice.
OVHcloud AI Deploy | OVHcloud Cloud GPU | |
|---|---|---|
Typ usługi | Zarządzany kontener (CaaS) | Instancja GPU wymagająca samodzielnego zarządzania (IaaS) |
Brak ruchu | Automatyczne zatrzymanie, 0 EUR | Opłaty naliczane również po wyłączeniu |
Maszyna wirtualna, sterowniki i CUDA | Gotowe | Wymagają samodzielnej instalacji i utrzymania |
Uruchomienie | Ładowany jest tylko obraz | Uruchomienie maszyny wirtualnej, stosu GPU i CUDA, a następnie załadowanie obrazu |
Endpoint HTTPS i autoskalowanie | W cenie | Wymagają samodzielnego skonfigurowania |
Monitorowanie GPU | Grafana w cenie | Wymaga samodzielnej konfiguracji |
Cena GPU L40S | 7,24 PLN netto/godz. | 6,40 PLN netto/godz. |
Zastosowanie | Zmienny ruch, zespół bez specjalistów MLOps | Stałe obciążenie przez całą dobę, potrzeba pełnej kontroli |
Wyłączona lub wstrzymana instancja jest nadal rozliczana według tej samej stawki. Dopiero ręczne przeniesienie jej do rezerwy (shelve) ogranicza opłaty do kosztu snapshotu.
Wybierz GPU, które będzie wykorzystywane przez Twoją usługę AI Deploy
Stawki godzinowe, rozliczanie za każdą minutę. Ruch sieciowy w cenie, bez zobowiązań.
Sprawdź pełny cennik Public CloudL4
Mniejsze modele, embeddingi3,88 PLNnetto/godz.
- NVIDIA L4, 24 GB
- od 1 do 8 GPU na replikę
- Gravelines (Francja)
L40S
Dostrajanie modeli LLM, przetwarzanie obrazów7,24 PLNnetto/godz.
- NVIDIA L40S, 48 GB
- od 1 do 8 GPU na replikę
- Gravelines (Francja)
A100
Modele LLM i widzenie komputerowe, duże partie danych13,80 PLNnetto/godz.
- NVIDIA A100, 80 GB
- od 1 do 8 GPU na replikę
- Gravelines (Francja)
H100
Duże modele LLM, wysoka przepustowość14,48 PLNnetto/godz.
- NVIDIA H100, 80 GB
- od 1 do 8 GPU na replikę
- Gravelines (Francja)
H200
Bardzo duże modele LLM, konfiguracje wieloprocesorowe98,49 PLNnetto/godz.
- 4 × NVIDIA H200, 141 GB
- Połączenie NVLink między 4 GPU
A10
Kompaktowe modele, NLP4,07 PLNnetto/godz.
- NVIDIA A10, 24 GB
- Gravelines (Francja)
V100S
Dostępne również w Kanadzie8,82 PLNnetto/godz.
- NVIDIA V100S, 32 GB
- GRA i BHS
CPU
Lekkie aplikacje, klasyczne uczenie maszynowe0,15 PLNnetto/godz./vCore
- Do 12 vCore na replikę
- GRA i BHS
Ceny na dzień 14.10.2026 r. Pamięć masowa rozliczana oddzielnie.
SPECYFIKACJA
Specyfikacja techniczna

GPU
H200, H100, A100, L40S, L4, A10, V100S
Zasoby na replikę
Do 8 dedykowanych procesorów GPU lub 12 vCore

Skalowanie
Od 0 do 10 replik, autoskalowanie w cenie
Sieć
HTTPS lub gRPC, ruch sieciowy w cenie

Regiony
Gravelines (FR), Beauharnois (CA)Dostępność
SLA 99,95%, wysoka dostępność (HA) od 2 replik
Przewodniki
- Dowiedz się więcej
Rozpocznij pracę z AI Deploy
Twoja pierwsza aplikacja – od obrazu do adresu URL. - Dowiedz się więcej
Skonfiguruj skalowanie
Autoskalowanie i możliwość zmniejszenia liczby replik do zera. - Dowiedz się więcej
Monitoruj aplikację
Metryki w Grafanie i logi aplikacji.