Zbuduj potok przetwarzania milionów zdarzeń w czasie rzeczywistym
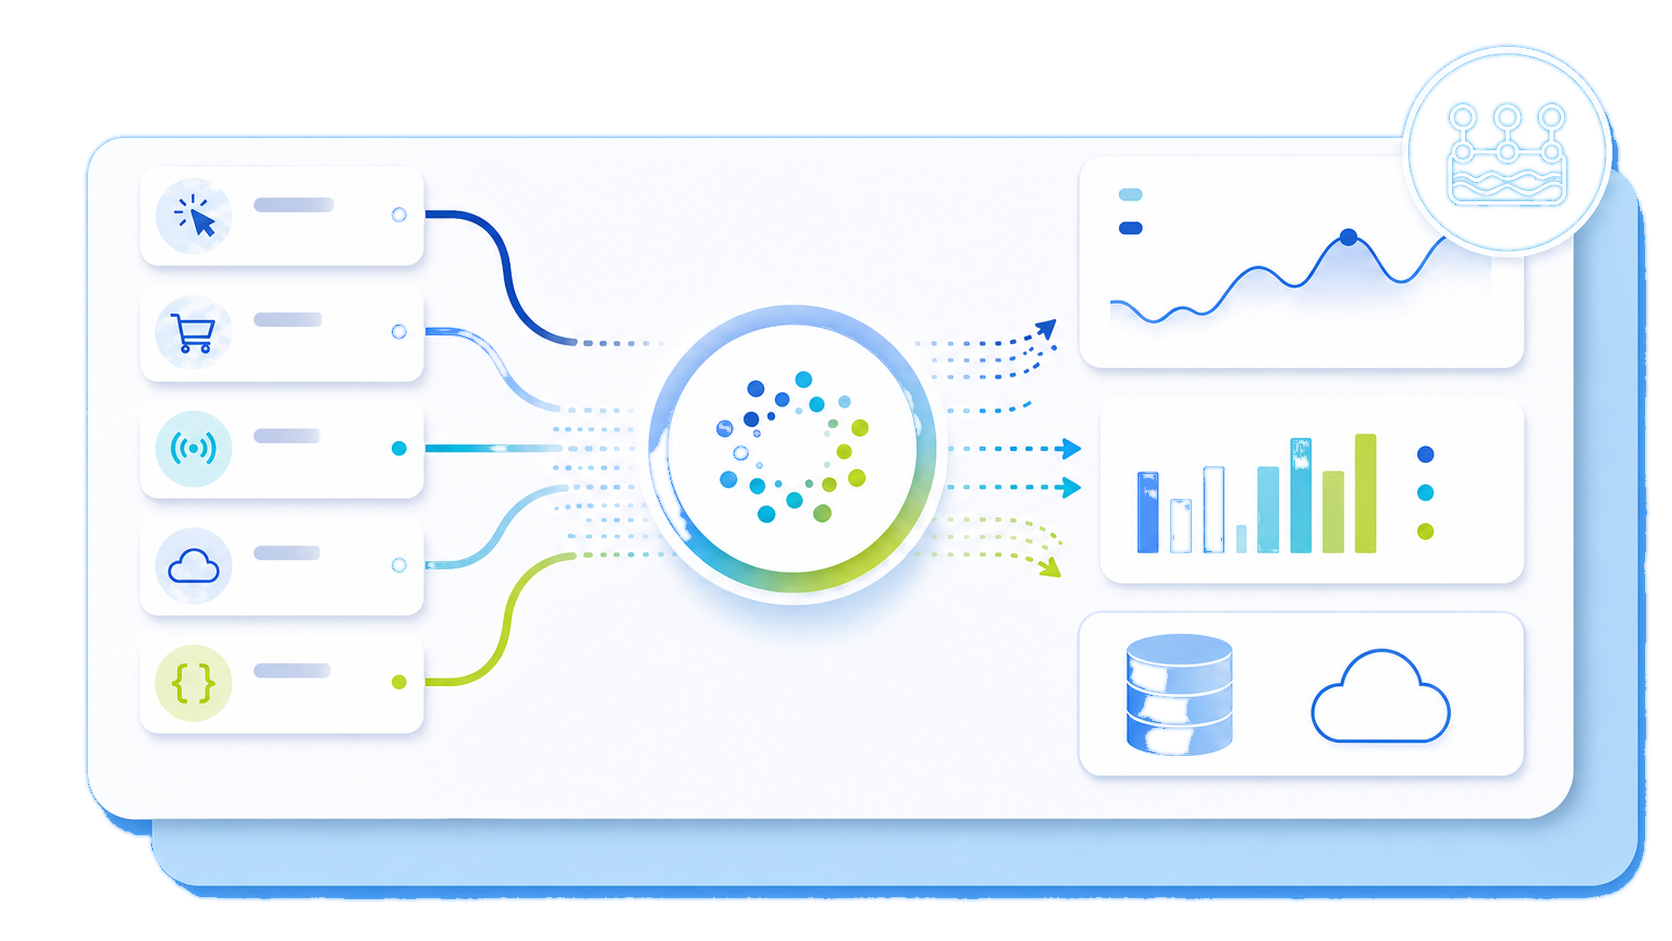
Dwie blokady potoku przetwarzania zdarzeń w czasie rzeczywistym
Bez niezawodnej infrastruktury do strumieniowego przesyłania danych, zapewniającej ich trwałość, rozproszeni producenci i konsumenci danych stają się ze sobą ściśle powiązani. Producenci to aplikacje, które generują zdarzenia i przesyłają je do tematów Kafka, natomiast konsumenci to usługi, które odczytują te zdarzenia. Producenci zapisują zdarzenia bezpośrednio w kolejkach, bazach danych lub niestandardowych usługach, a gdy konsument przestaje działać lub nie nadąża z przetwarzaniem zdarzeń, producent zostaje zablokowany albo zaczyna gubić zdarzenia.
Ponadto PostgreSQL i podobne bazy danych OLTP w środowisku Public Cloud są przeznaczone do wykonywania operacji na poziomie poszczególnych wierszy: wstawiania, aktualizowania i usuwania danych. Nie są przeznaczone do skanowania miliardów wierszy, agregowania danych według wielu wymiarów ani aktualizowania pulpitów nawigacyjnych co minutę. Wraz ze wzrostem liczby zdarzeń zapytania, które wcześniej zwracały wyniki w ciągu 200 ms, zaczynają trwać kilka sekund, następnie kilkadziesiąt sekund, a w końcu nawet kilka minut. System staje się blokadą utrudniającą podejmowanie decyzji dotyczących produktu.
Działaj bez obaw nawet na skalę dużego przedsiębiorstwa

Architektura referencyjna: Apache Kafka + ClickHouse
Apache Kafka jako fundament infrastruktury przetwarzania strumieniowego
Kafka pełni rolę centralnego układu nerwowego obsługującego zdarzenia. Producenci zapisują zdarzenia w tematach, które są logicznie uporządkowane i podzielone na partycje rozmieszczone pomiędzy różnymi brokerami. Każda partycja może być niezależnie odczytywana przez konsumentów, co pozwala poziomo skalować prędkość transmisji danych w Kafce. Grupy konsumentów odczytują dane z tych partycji, a każdy konsument w grupie odpowiada za określony podzbiór partycji.
Partycje mają kluczowe znaczenie dla prędkości transmisji danych. Temat z większą liczbą partycji może obsługiwać więcej operacji zapisu i większą liczbę konsumentów równolegle, z ograniczeniem do liczby partycji. Grupy konsumentów umożliwiają ponowne odczytywanie i przetwarzanie zdarzeń. Schematami danych aplikacji zarządza się zazwyczaj oddzielnie, często za pomocą Schema Registry, dzięki czemu producenci i konsumenci mogą być rozwijani niezależnie, bez zakłócania wzajemnego działania. Zdarzenia są przechowywane przez konfigurowalny okres, co daje możliwość ich ponownego odczytania bez konieczności przetwarzania danych od nowa ze źródła. Ta trwałość przechowywania danych i stałe oddzielenie producentów od konsumentów sprawiają, że Kafka stanowi niezawodny fundament obsługi strumieni zdarzeń o dużym natężeniu.
ClickHouse jako warstwa OLAP działająca w czasie rzeczywistym
ClickHouse to kolumnowa, rozproszona baza danych przeznaczona do obsługi obciążeń roboczych związanych z analizą danych. Przechowuje dane kolumnowo, a nie wierszowo, dzięki czemu podczas wykonywania zapytań może pomijać niepotrzebne kolumny i uzyskiwać wysoki stopień kompresji danych. W połączeniu z silnikiem przechowywania danych, zoptymalizowanym pod kątem odczytu sekwencyjnego i stosowania warunków filtrowania już na etapie odczytu danych (predicate pushdown), pozwala to ClickHouse szybko skanować miliardy wierszy i zwracać zagregowane wyniki w ciągu milisekund. Nowe zdarzenia mogą być zapisywane w czasie rzeczywistym, a ClickHouse może wstępnie agregować je za pomocą widoków zmaterializowanych, które są aktualizowane wraz z napływem danych. Umożliwia to ciągłą aktualizację pulpitów nawigacyjnych i generowanie alertów bez konieczności oczekiwania na wykonanie zadania wsadowego lub kolejny zaplanowany cykl przetwarzania ETL. Baza danych została zaprojektowana z myślą o skalowaniu poziomym – wraz ze wzrostem liczby zdarzeń można dodawać kolejne węzły, zwiększając pojemność pamięci masowej i moc obliczeniową.
Object Storage jako warstwa „zimnych” danych do przechowywania starszych zdarzeń
Nie wszystkie dane muszą być przechowywane w hot storage – utrzymywanie wszystkich zdarzeń na lokalnych dyskach ClickHouse staje się kosztowne i zbędne. Typowym rozwiązaniem jest przenoszenie starszych danych do usługi OVHcloud Object Storage (zgodnej z S3)*, przy jednoczesnym pozostawieniu najnowszych danych w ClickHouse w celu zapewnienia szybkiego wykonywania zapytań. Zdarzenia starsze niż określony próg czasowy są przechowywane w tej warstwie i odczytywane na żądanie, gdy potrzebna jest bardziej szczegółowa analiza danych historycznych. Takie podejście obniża koszty długoterminowego przechowywania danych, zachowując możliwość wykonywania zapytań obejmujących cały zbiór danych.
W przypadku wielu praktycznych use case związanych z przetwarzaniem danych warstwa szybkiego dostępu (ClickHouse) przechowuje dane z ostatnich dni lub tygodni na potrzeby pulpitów nawigacyjnych i alertów w czasie rzeczywistym, natomiast warstwa „zimnych” danych (OVHcloud Object Storage) przechowuje dane historyczne z wielu miesięcy lub lat na potrzeby zapewnienia zgodności z przepisami, audytów i okresowych pogłębionych analiz. Takie rozdzielenie pozwala utrzymać przewidywalne koszty operacyjne i skalować potok przetwarzania danych bez napotykania sztywnych ograniczeń pojemności pamięci masowej aplikacji.
Natywna integracja ClickHouse za pomocą silnika Kafka
ClickHouse ma wbudowany silnik tabel Kafka, który umożliwia bezpośrednią subskrypcję tematów Kafka. Definiujesz tabelę korzystającą z silnika Kafka, podajesz nazwę tematu, listę brokerów i grupę konsumentów, a ClickHouse zaczyna pobierać zdarzenia z platformy Kafka, traktując je jak wiersze zwykłej tabeli. Jest to bezpośrednia, natywna integracja, która nie wymaga dodatkowego middleware. Silnik Kafka w ClickHouse jest przeznaczony do strumieniowego ładowania danych. Odczytuje rekordy z tematu, parsuje je zgodnie z określonym przez Ciebie formatem (JSON, Avro, Protobuf itp.) i udostępnia jako wiersze, na których można wykonywać zapytania lub które można wstawiać do innych tabel.
Dostosuj strukturę napływających zdarzeń, aby przyspieszyć podejmowanie decyzji
Wstępnie agreguj regularnie obliczane wskaźniki
Widoki zmaterializowane na bieżąco obliczają sumy, wskaźniki i metryki z podziałem na grupy w miarę napływu zdarzeń, ograniczając konieczność wielokrotnego wykonywania tych samych operacji podczas obsługi zapytań.
Dostosuj tabele do wzorców dostępu do danych
Sortuj dane według czasu i wymiarów najczęściej wykorzystywanych do filtrowania, aby ograniczyć odczyt niepotrzebnych rekordów podczas analizy incydentów.
Odczytuj tylko potrzebne pola
Wybór kolumn ogranicza skanowanie danych do atrybutów wymaganych przez dany pulpit nawigacyjny, alert lub zapytanie eksploracyjne.
Dostosuj okresy przechowywania danych do potrzeb
Oddziel często odczytywane rekordy od danych wykorzystywanych rzadziej. Tabele zaprojektowane z uwzględnieniem okresów przechowywania danych pozwalają utrzymać czas wykonywania analiz na potrzeby widoków operacyjnych poniżej sekundy, a jednocześnie umożliwiają sprawne badanie incydentów nawet przy rosnącej ilości danych historycznych.
Koszt oczekiwania
Przypisz każdej warstwie jasno określoną funkcję
Fundament infrastruktury przetwarzania strumieniowego
Buforuj i porządkuj strumienie zdarzeń o dużym natężeniu oraz umożliwiaj ich ponowne odtwarzanie, aby producenci pozostawali niezależni od procesów przetwarzania danych i obciążeń roboczych związanych z analizą danych.
Obsługa zapytań analitycznych
Udostępniaj aktualne dane o zdarzeniach na potrzeby szybkiego wykonywania zapytań operacyjnych, obsługi pulpitów nawigacyjnych i badania incydentów, utrzymując jednocześnie oddzielne środowisko do obsługi obciążeń analitycznych.
Warstwa „zimnych” danych
Przechowuj starsze dane historyczne poza pamięcią masową zoptymalizowaną pod kątem wydajności. Takie rozdzielenie zapewnia długoterminowy dostęp do danych bez konieczności przechowywania wszystkich zdarzeń w warstwie analitycznej szybkiego dostępu. Typowym rozwiązaniem jest przenoszenie starszych danych do usługi OVHcloud Object Storage
Zarządzana obsługa operacyjna i wdrażanie
OVHcloud zarządza replikacją, tworzeniem kopii zapasowych i monitorowaniem w całej architekturze usług. Zespoły mogą wdrażać zasoby za pomocą Panelu klienta OVHcloud lub definiować odtwarzalne środowiska przy użyciu narzędzia Terraform.
Wdróż potok przetwarzania zdarzeń w czasie rzeczywistym w kilka minut
Zespołom, które potrzebują pomocy w doborze odpowiednich zasobów infrastruktury, OVHcloud zapewnia bezpośredni kontakt ze specjalistami ds. infrastruktury danych, również w zakresie usługi Managed Databases for PostgreSQL. Mogą oni ocenić aktualną liczbę przetwarzanych zdarzeń i charakterystykę zapytań oraz porównać koszty proponowanego rozwiązania z kosztami obecnie wykorzystywanej infrastruktury. Niezależnie od tego, czy jesteś inżynierem danych, który potrzebuje wyników analiz miliardów wierszy w czasie rzeczywistym bez konieczności poświęcania dużej ilości czasu na zarządzanie infrastrukturą, czy dyrektorem ds. danych, któremu zależy na ograniczeniu obciążeń operacyjnych i przewidywalnych kosztach korzystania z chmury, zestaw usług zarządzanych eliminuje dodatkowy nakład pracy związany z obsługą infrastruktury, a jednocześnie pozwala zachować przenośność architektury opartej na technologiach open source.
*S3 jest zastrzeżonym znakiem towarowym Amazon Technologies, Inc. Usługi OVHcloud nie są sponsorowane ani zatwierdzane przez Amazon Technologies, Inc., ani w żaden sposób z nią powiązane.
Poznaj nasze usługi przetwarzania strumieniowego, analityki i przechowywania danych, a następnie przekształcaj duże ilości zdarzeń w wiarygodne wyniki analiz, które można uzyskiwać za pomocą zapytań, ograniczając jednocześnie nakład pracy związany z utrzymaniem infrastruktury.