Construir um pipeline de eventos em tempo real para milhões de eventos
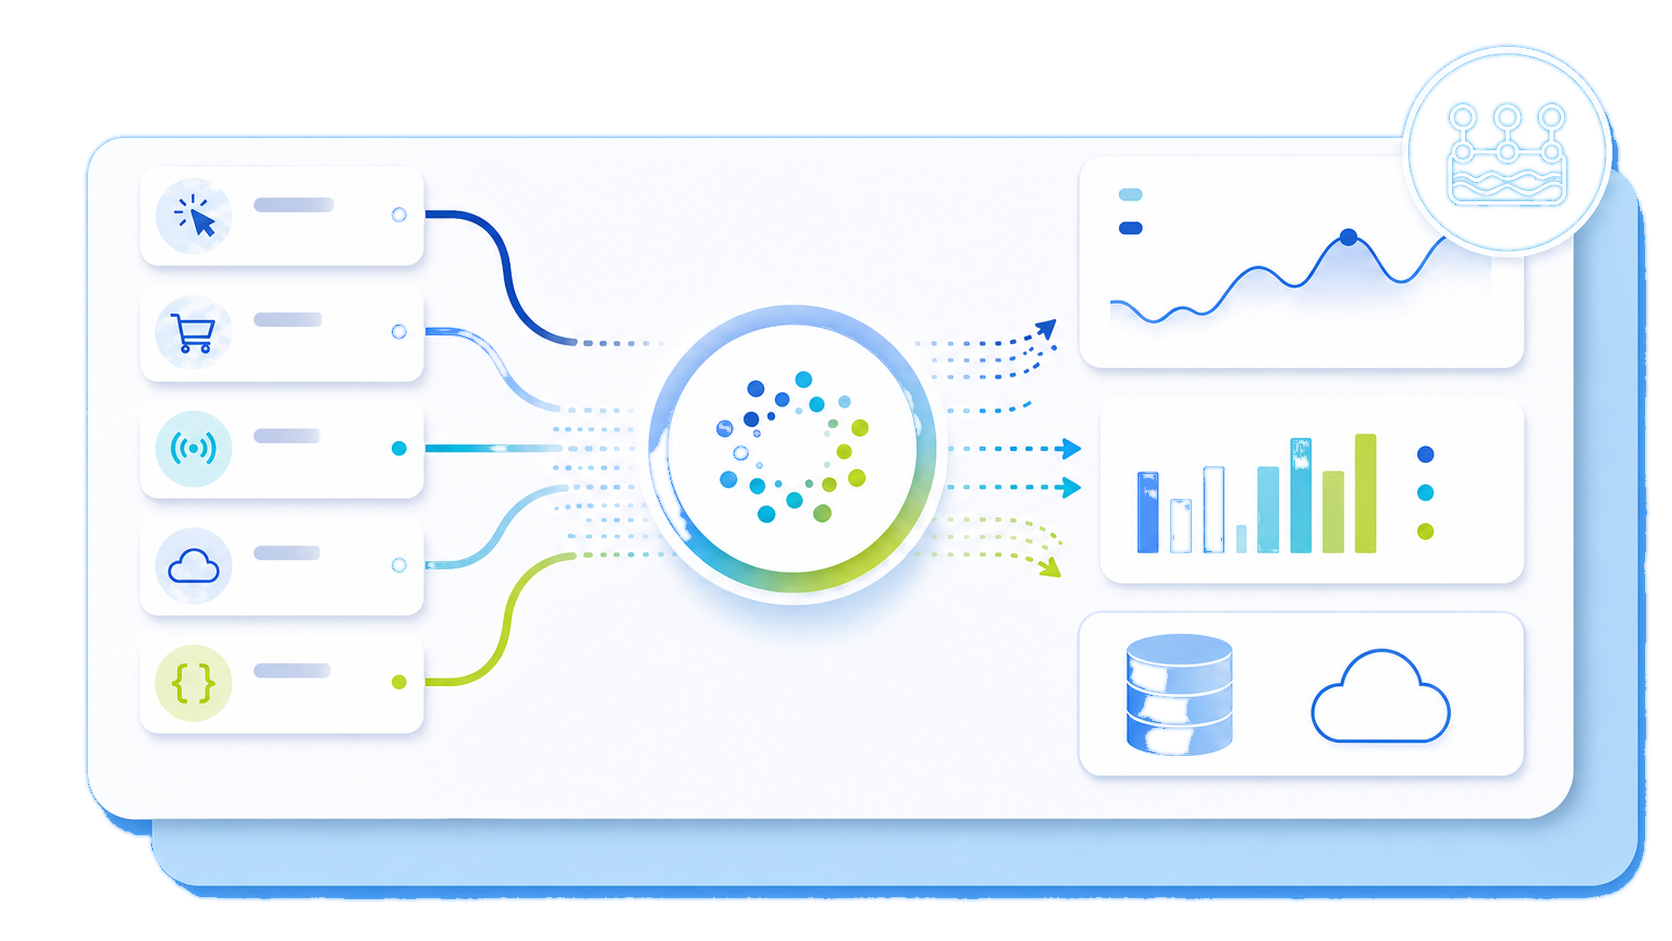
Os dois pontos de congestionamento de um pipeline de eventos em tempo real
Sem uma base de streaming duradoura, os produtores e consumidores de dados distribuídos ficam fortemente interligados. Os produtores são as aplicações que geram e enviam eventos para tópicos do Kafka, enquanto os consumidores são os serviços que leem esses eventos. Os produtores escrevem diretamente em filas, bases de dados ou serviços personalizados e, quando um consumidor fica inativo ou apresenta atrasos, o produtor bloqueia ou começa a descartar eventos.
Além disso, o PostgreSQL e outras bases de dados OLTP semelhantes na Cloud Pública foram concebidos para operações ao nível da linha: inserções, atualizações, eliminações. Não foram concebidos para analisar milhares de milhões de linhas, agregar dados em várias dimensões ou atualizar painéis de controlo a cada minuto. À medida que o volume de eventos aumenta, as consultas que costumavam devolver resultados em 200 ms começam a demorar segundos, depois dezenas de segundos, e depois minutos. O sistema torna-se um congestionamento para as decisões de produto.
Operar com confiança à escala empresarial

Uma arquitetura de referência: Apache Kafka + ClickHouse
Apache Kafka como base de streaming
O Kafka atua como o sistema nervoso central para eventos. Os produtores enviam eventos para tópicos, que são ordenados logicamente e repartidos pelos brokers. Cada repartição pode ser consumida de forma independente, que é a forma como o Kafka escala o processamento horizontalmente. Os grupos de consumidores leem a partir destas repartições, e cada consumidor num grupo é responsável por um subconjunto das repartições.
As repartições são a chave para o processamento. Um tópico com mais repartições pode processar mais escritas e mais consumidores em paralelo, até ao número de repartições. Os grupos de consumidores permitem a repetição. Os esquemas para aplicações são normalmente geridos separadamente, frequentemente com um Schema Registry, para que os produtores e consumidores possam evoluir sem se prejudicarem mutuamente. Os eventos são mantidos durante um período de retenção configurável, o que lhe dá uma janela para repetir dados sem ter de reprocessar a partir da fonte. Esta durabilidade e desacoplamento contínuo é o que torna o Kafka uma base fiável para streams de eventos de alto volume.
ClickHouse como camada OLAP em tempo real
O ClickHouse é uma base de dados colunar e distribuída, concebida para cargas de trabalho analíticas. Armazena dados por coluna em vez de por linha, o que significa que pode ignorar colunas irrelevantes durante as consultas e comprimir os dados intensamente. Juntamente com o seu motor de armazenamento, que está otimizado para leituras sequenciais e pushdown de predicados, isto permite ao ClickHouse analisar milhares de milhões de linhas rapidamente e apresentar resultados agregados em milésimos de segundo. Podem ser carregados novos eventos em tempo real, e o ClickHouse pode pré-agregá-los utilizando vistas materializadas que se atualizam à medida que os dados chegam. Isto significa painéis de controlo e alertas contínuos, sem esperar por uma tarefa em batch ou por uma janela de ETL. A base de dados foi concebida para crescer horizontalmente, adicionando nós para aumentar a capacidade de armazenamento e de computação à medida que o volume de eventos cresce.
Armazenamento de Objetos como uma camada de cold-data para eventos antigos
Nem todos os dados precisam de permanecer no armazenamento ativo; manter todos os eventos no ClickHouse em discos locais torna-se dispendioso e desnecessário. O padrão comum é transferir dados mais antigos para o Armazenamento de Objetos da OVHcloud (compatível com S3)*, mantendo os dados recentes no ClickHouse para consultas rápidas. Os eventos mais antigos do que um limiar configurado são consultados quando necessário, para análises históricas mais aprofundadas. Esta abordagem reduz o custo da retenção a longo prazo, preservando a capacidade de executar consultas em todo o conjunto de dados.
Em muitos casos de utilização reais de processamento, a camada ativa (ClickHouse) armazena dados relativos a dias ou semanas para painéis de controlo e alertas em tempo real, enquanto a camada inativa (OVHcloud Object Storage) armazena um histórico de meses ou anos para fins de conformidade, auditorias e análises aprofundadas periódicas. Esta separação mantém os custos operacionais previsíveis e permite que o pipeline seja dimensionado sem atingir um limite rígido de armazenamento da aplicação.
A integração nativa do motor Kafka no ClickHouse
O ClickHouse possui um motor de tabela Kafka integrado que lhe permite subscrever diretamente tópicos do Kafka. Define uma tabela com o motor Kafka, especifica o nome do tópico, a lista de brokers e o grupo de consumidores, e o ClickHouse começa a consumir eventos do Kafka como se fossem linhas numa tabela normal. Esta é uma integração direta e nativa que não requer middleware adicional. O motor Kafka no ClickHouse foi concebido para o carregamento de streaming. Lê registos do tópico, analisa-os de acordo com o formato especificado (JSON, Avro, Protobuf, etc.) e apresenta-os como linhas que podem ser consultadas ou inseridas noutras tabelas.
Moldar eventos recebidos para decisões mais rápidas
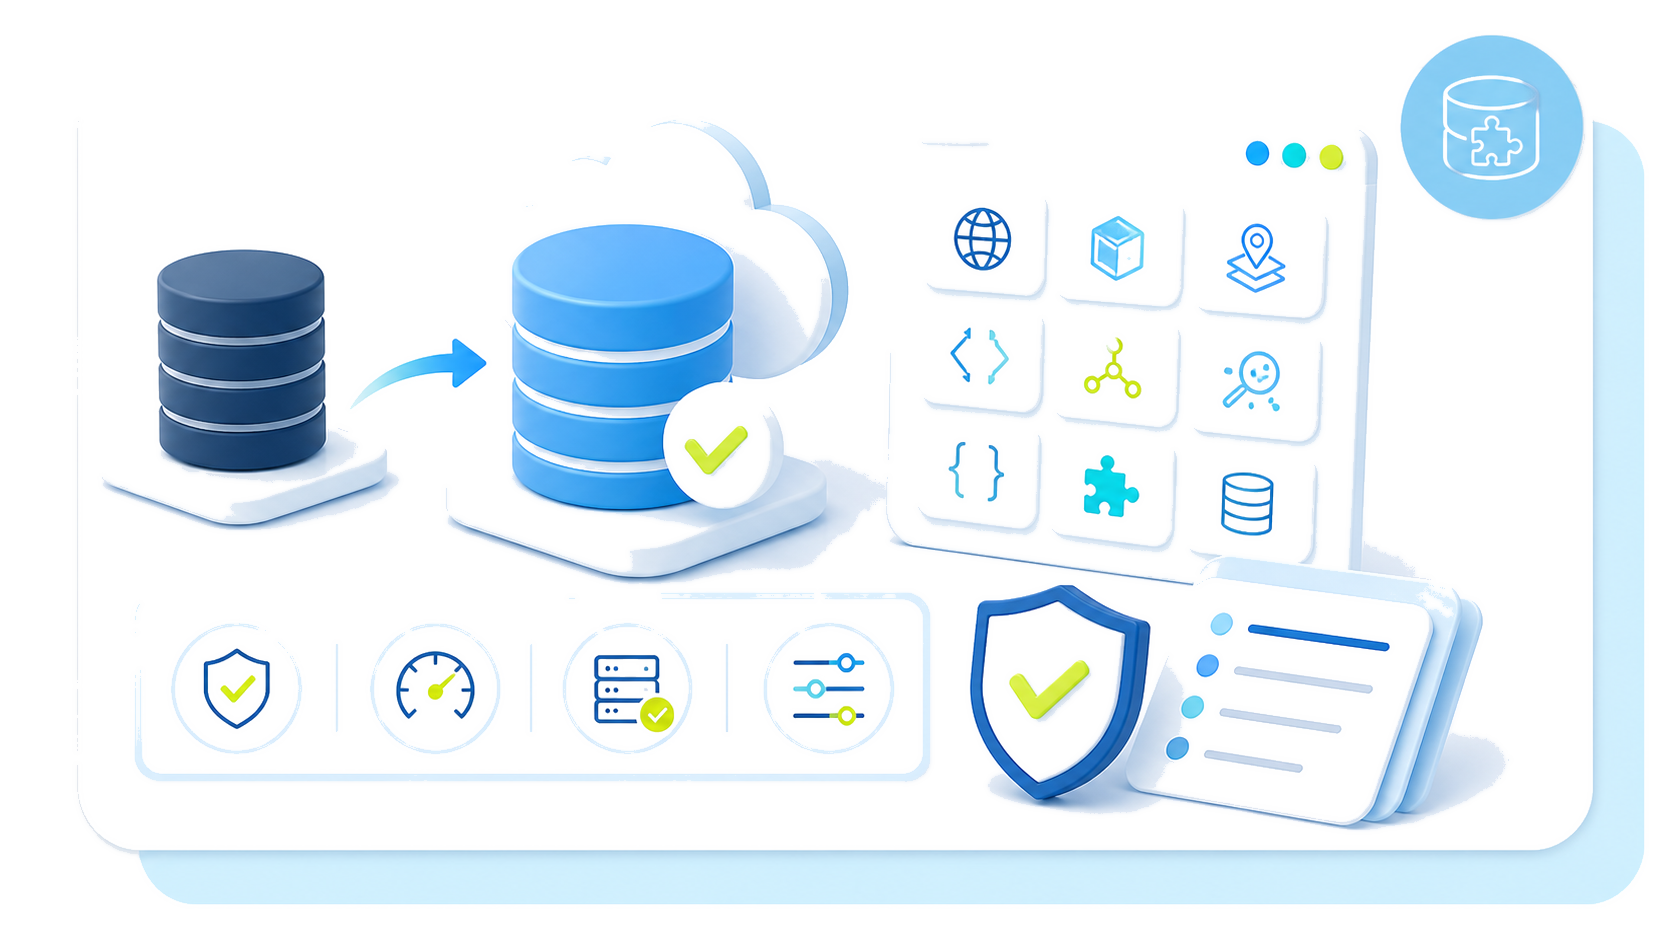
Pré-agregar medidas recorrentes
As vistas materializadas calculam continuamente totais, taxas e métricas agrupadas à medida que os eventos chegam, reduzindo o trabalho repetido no momento da consulta.
Alinhar tabelas com padrões de acesso
Ordenar os dados por hora e dimensões frequentemente filtradas, para que as análises incluam menos registos irrelevantes.
Ler apenas campos úteis
A seleção de colunas limita a leitura aos atributos necessários para cada painel de controlo, alerta ou consulta exploratória.
Conceber a retenção em torno da procura
Separar os registos consultados frequentemente dos dados menos ativos. As tabelas com reconhecimento de retenção ajudam a manter análises em menos de um segundo para visualizações operacionais, ao mesmo tempo que garantem a viabilidade das investigações à medida que os registos históricos aumentam.
O custo da espera
Atribuir a cada camada uma responsabilidade clara
Base de streaming
Armazenar em buffer, ordenar e reproduzir fluxos de eventos de grande volume, para que os produtores permaneçam independentes das cargas de trabalho de processamento e análise.
Serviço analítico
Expor eventos recentes para consultas operacionais rápidas, painéis de controlo e investigações, mantendo simultaneamente um ambiente dedicado às necessidades analíticas.
Nível de cold-data
Manter os registos mais antigos fora do armazenamento focado no desempenho. Esta separação permite o acesso a longo prazo sem manter todos os eventos no caminho analítico ativo. O padrão comum consiste em transferir os dados mais antigos para o Armazenamento de Objetos OVHcloud
Operações e entrega geridas
A OVHcloud gere a replicação, as cópias de segurança e a monitorização em toda a arquitetura do serviço. As equipas podem implementar recursos através do Painel de Controlo da OVHcloud ou definir ambientes repetíveis com o Terraform.
Implementar um pipeline de eventos em tempo real em minutos
Para as equipas que pretendem ajuda no dimensionamento da estrutura, a OVHcloud oferece acesso direto a especialistas em infraestruturas de dados, nomeadamente as Managed Databases for PostgreSQL, que podem avaliar os seus volumes de eventos e padrões de consulta atuais e fornecer uma comparação de custos em relação à sua estrutura existente. Quer seja um Engenheiro de Dados que necessita de resultados em tempo real com milhares de milhões de linhas com um tempo mínimo de infraestrutura ou um Diretor de Dados que pretende reduzir a carga operacional e ter custos de Cloud previsíveis, a estrutura gerida elimina os custos operacionais, mantendo a arquitetura portátil e de código aberto.
*S3 é uma marca registada da Amazon Technologies, Inc. Os serviços da OVHcloud não são patrocinados, aprovados nem afiliados, de forma alguma, à Amazon Technologies, Inc.
Explore os nossos serviços de streaming, analíticos e de armazenamento e, em seguida, transforme eventos de elevado volume em informações fiáveis e consultáveis, reduzindo simultaneamente o trabalho operacional necessário para executar a infraestrutura subjacente.