Gérez les pics de trafic sans interruption et évoluez en quelques minutes
Maintenez vos services en ligne pendant des pics planifiés ou face à une augmentation imprévue. Placez un Load Balancer managé avant un parc d'instances Compute à la demande, puis augmentez la capacité sans avoir à repenser votre application au préalable. 
Noms de domaine illustration

Distinguez la demande réelle des attaques avant d’évoluer
Analysez l'histoire derrière chaque pic de trafic soudain. Le taux de requêtes, le processeur, la latence et la forme du trafic fournissent la profondeur technique nécessaire pour détecter les vraies personnes, les pannes ou les activités hostiles. Pour gérer les pics de trafic sans interruption de service, répartissez le trafic entrant, ajoutez de la capacité, utilisez la mise en cache et optimisez la base de données. La protection anti-DDoS traite les flux malveillants. Cette compréhension permet de gérer les pics de trafic, d'éviter les interruptions du site en cas de forte affluence et de prévenir les pannes, y compris celles dues à une mise à l’échelle mal adaptée.
[object Object]

Garde-fous mesurables pour les pics de trafic

Bénéficiez d'un SLA de 99,99 % pour le calcul et l'équilibrage de charge, ainsi que d'une protection anti-DDoS jusqu'à 10 Tbit/s.
Engagement de niveau de service (SLA) de 99,99 %
Mitigation anti-DDoS
Mitigation incluse
Limites de capacité de charge
Limites de charge publiées

Renforcez la résilience du routage, du calcul et des données

Maintenir le flux des requêtes au niveau du point d'entrée

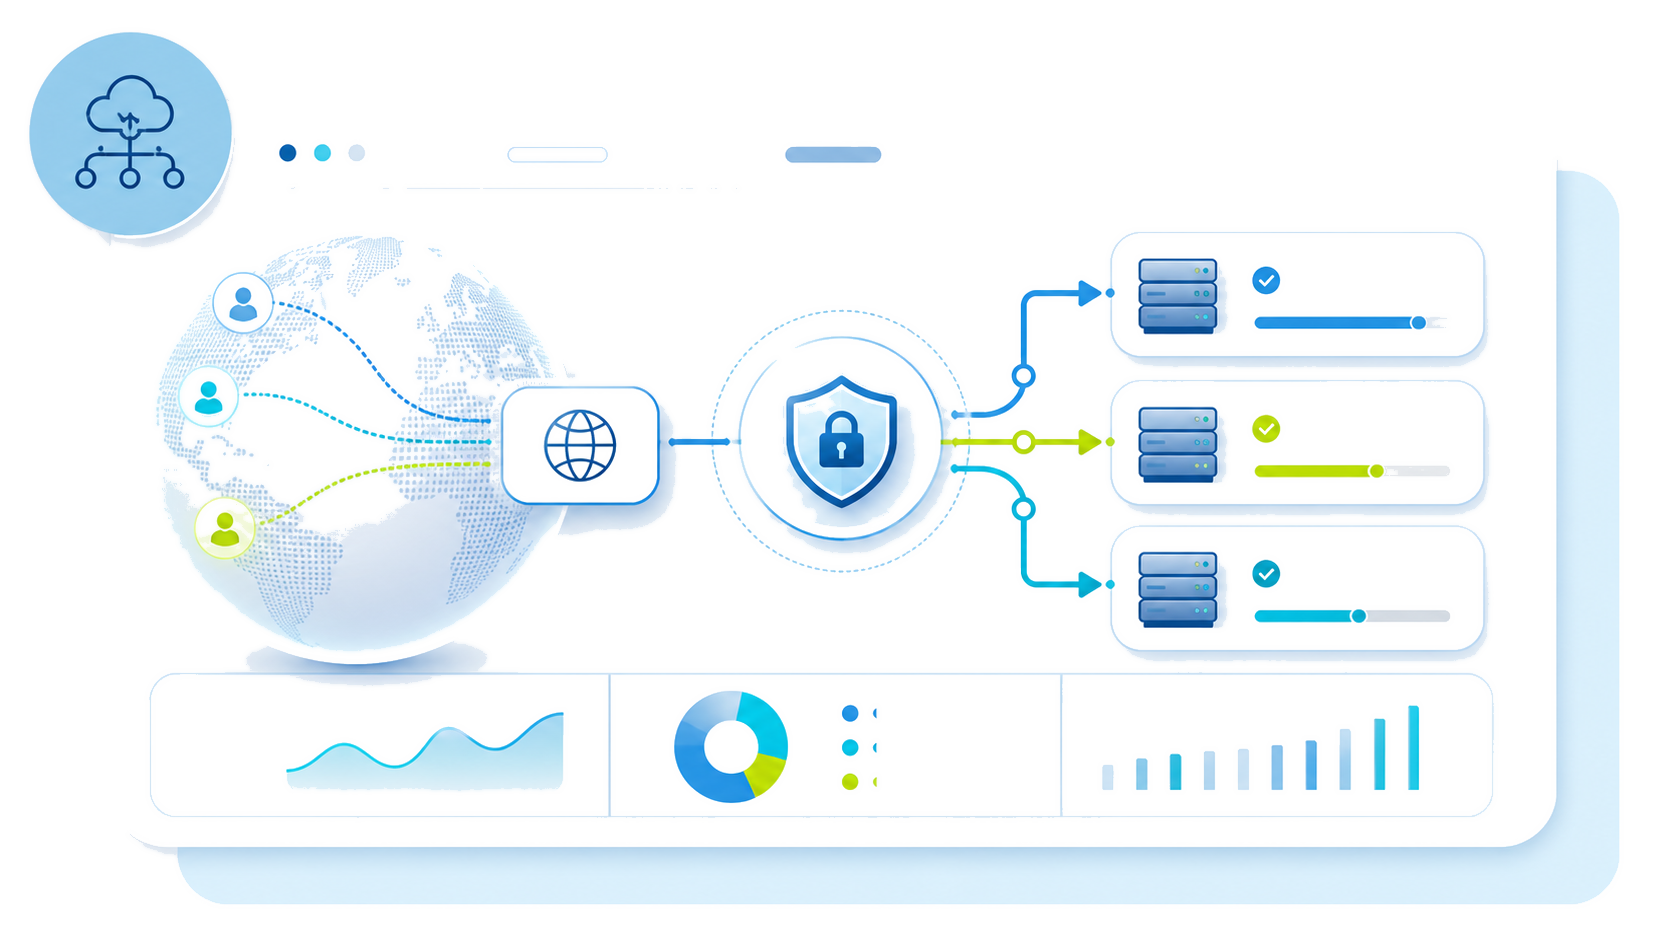
Le Load Balancer managé vérifie l'état de santé des back-ends, termine le TLS et utilise un routage pondéré pour contrôler la distribution des requêtes. Si un serveur devient indisponible, le basculement automatique redirige les utilisateurs et utilisatrices vers les nœuds disponibles.

Adapter la capacité de calcul à la demande observée

Mettez à l'échelle un parc d'instances Compute Gen3 identiques derrière la couche de routage. Choisissez la capacité en vous appuyant sur des modèles de trafic mesurés plutôt que sur des suppositions, puis ajoutez des nœuds de façon contrôlée à mesure que la demande augmente. Lorsqu'une entreprise a besoin de résilience géographique, déployez sur trois zones de disponibilité à Paris ou à Milan.

Protéger la base de données contre les charges déplacées

Une capacité supplémentaire sur le front-end peut exposer une contrainte de base de données au lieu de la résoudre. Protégez les pools de connexion, mettez en cache les données fréquemment consultées en mémoire et examinez les requêtes lentes de recherche ou de commande avant de poursuivre l’évolution. Ces vérifications identifient les goulots d'étranglement potentiels que des nœuds d'application supplémentaires ne peuvent pas supprimer. L’anti-DDoS traite le trafic web hostile, tandis que cette architecture en couches gère les pics légitimes.

Préservez une adresse de service stable à chaque changement

OpenStack OctaviaFloating IPTLS
OpenStack Octavia achemine les requêtes vers des back-ends sains, termine le TLS et utilise une distribution pondérée pour éviter qu'une machine virtuelle ne devienne le point de blocage. Une Floating IP préserve l'adresse publique pendant que les équipes remplacent, redimensionnent ou basculent les ressources dans le délai imparti.

Sélectionnez les options en fonction des mesures de trafic, puis testez les performances dans des conditions de vente flash et d'événement médiatique. Ces stratégies aident à gérer les pics de trafic sans interruption de service et à protéger l'expérience utilisateur tout au long de la fenêtre de mise à l'échelle.
[object Object]
Une date de lancement connue donne aux équipes le temps de tester la configuration complète sous une forte demande représentative. Créez des instances Compute temporaires à partir d'une image de référence réutilisable, validez les parcours client et utilisez un équilibrage de charge pondéré pour introduire de la capacité avant l'arrivée des internautes. Cette stratégie est efficace pour le commerce saisonnier, la mise à disponibilité de billets et la couverture médiatique programmée. Cette infrastructure supplémentaire étant temporaire, l'entreprise évite ainsi de payer pour une capacité statique inutilisée pendant les périodes plus calmes.

Une attention soudaine nécessite une réponse rapide et mesurée. Faites évoluer les instances de calcul à la demande, validez chaque nouveau nœud et distribuez le trafic entrant sur plusieurs serveurs disponibles. Appliquez une limitation de débit lorsqu'une ressource critique en aval, telle que l'authentification, la gestion des stocks ou le traitement des paiements, doit être protégée. N'étendez pas automatiquement chaque dépendance : lisez les indicateurs de latence et d'erreur pour déterminer où se situe la contrainte.

L'hébergement haute disponibilité nécessite une protection contre les variations de la demande comme contre les pannes de localisation. Une architecture multi-AZ réduit la dépendance à une seule zone de disponibilité, tandis qu'une capacité statique offre une marge de manœuvre immédiate pour les fluctuations courantes. Les équipes peuvent ensuite ajouter des ressources rapidement lorsque les conditions dépassent cette base de référence. Une fois le trafic normalisé, confirmez que les files d'attente, la latence et les erreurs restent stables avant de supprimer les nœuds temporaires.
Une date de lancement connue donne aux équipes le temps de tester la configuration complète sous une forte demande représentative. Créez des instances Compute temporaires à partir d'une image de référence réutilisable, validez les parcours client et utilisez un équilibrage de charge pondéré pour introduire de la capacité avant l'arrivée des internautes. Cette stratégie est efficace pour le commerce saisonnier, la mise à disponibilité de billets et la couverture médiatique programmée. Cette infrastructure supplémentaire étant temporaire, l'entreprise évite ainsi de payer pour une capacité statique inutilisée pendant les périodes plus calmes.

Rendez chaque réponse aux pics de trafic reproductible

Capacité de référence

Effectuez des tests de charge sur les principaux parcours utilisateur et enregistrez les endroits où les performances de calcul, de réseau ou de base de données sont surchargées. Cette référence soutient un plan réaliste reposant sur la demande actuelle.

Build réutilisable

Maintenez un snapshot d'instance ou une image de référence testés. Chaque nouveau nœud peut alors partager la même configuration d'application, de sécurité et de réseau.

Visibilité opérationnelle

Mettez en place, avant l'événement, un suivi du volume de requêtes, de la latence, des erreurs, du CPU, des connexions et des données fréquemment consultées. Les alertes aident les équipes à réagir plus rapidement à une demande inattendue.

Maturité de la mise à l'échelle

Utilisez l'expansion de machine virtuelle scriptée pour gérer les pics de trafic ou une augmentation soudaine liée aux réseaux sociaux.

Déployez la protection contre les augmentations soudaines via quatre workflows

Établir une base de référence et protéger

Quantifiez le trafic attendu et soudain, définissez les objectifs de service et testez en charge les parcours critiques. Confirmez que la mitigation des attaques est active afin que les équipes puissent gérer une demande accrue sans confondre l'activité hostile avec une croissance légitime.

Construire et automatiser

Décrivez la configuration du parc, du réseau et de l'équilibrage avec Terraform. Du code d'infrastructure reproductible aide les ingénieurs à ajouter de la capacité de manière cohérente en quelques minutes ou heures, plutôt que de reconstruire manuellement les serveurs en plein incident.

Valider les données et l'expérience

Testez les connexions à la base de données, les taux d'erreur et les temps de chargement en cas d'augmentation du trafic. Incluez les pannes de nœuds et de zones pour confirmer que l'architecture maintient une expérience utilisateur fluide en cas d’indisponibilité des composants individuels.

Exploiter et récupérer

Documentez les déclencheurs de mise à l'échelle, les circuits d'approbation et de contact, les procédures de rollback, ainsi que les responsabilités associées. Définissez le moment où il est sûr de retirer la capacité temporaire après un pic viral, en vous basant sur la stabilité constatée du service plutôt que sur la première baisse de trafic.

Supprimer la capacité temporaire lorsque les performances se stabilisent
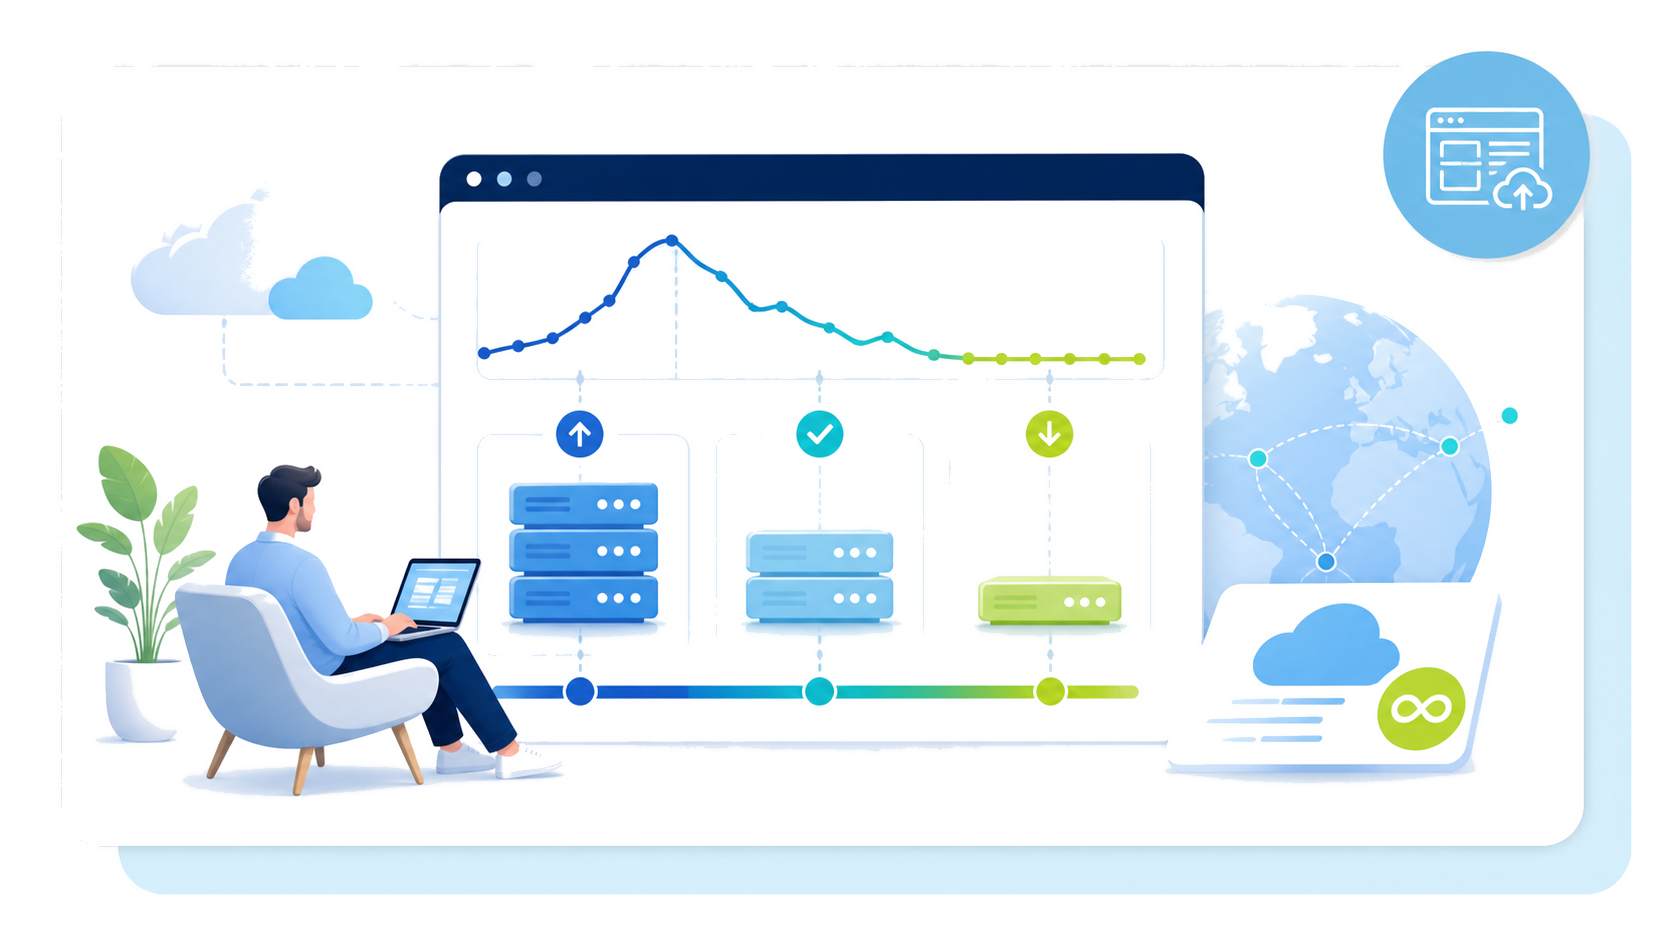
La facturation à la seconde des instances Compute, avec un minimum de 60 secondes, disponible à partir de mai 2026, permet d’aligner la capacité temporaire sur chaque pic. Observez le moment où la demande applicative revient à la normale, où la file d'attente des requêtes se vide et où la vitesse du service se stabilise avant de supprimer efficacement les nœuds excédentaires. Cette approche mesurée permet d’assurer le contrôle des coûts sans risquer de pannes. Le trafic sortant illimité et non facturé disponible dans la plupart des régions, peut réduire l'incertitude inutile liée à l'hébergement cloud pour du contenu à fort volume de données. Vérifiez la disponibilité régionale et les conditions applicables à votre activité.
[object Object]
Préparez votre infrastructure avant la prochaine montée en charge
Démarrez un essai Public Cloud ou activez un Load Balancer managé. Déployez, testez et affinez votre réponse avant que la demande n'augmente.
Activer le Load Balancer