Infra as a Service

Gestionad picos de tráfico sin tiempo de inactividad y escalad en minutos
Mantened vuestros servicios en línea durante picos planificados y crecimientos inesperados. Colocad un equilibrador de carga gestionado ante un conjunto de instancias de computación bajo demanda y, a continuación, ampliad la capacidad sin rediseñar primero vuestra aplicación. 
Ilustración de nombres de dominio

Distinguid la demanda genuina de los ataques antes de escalar
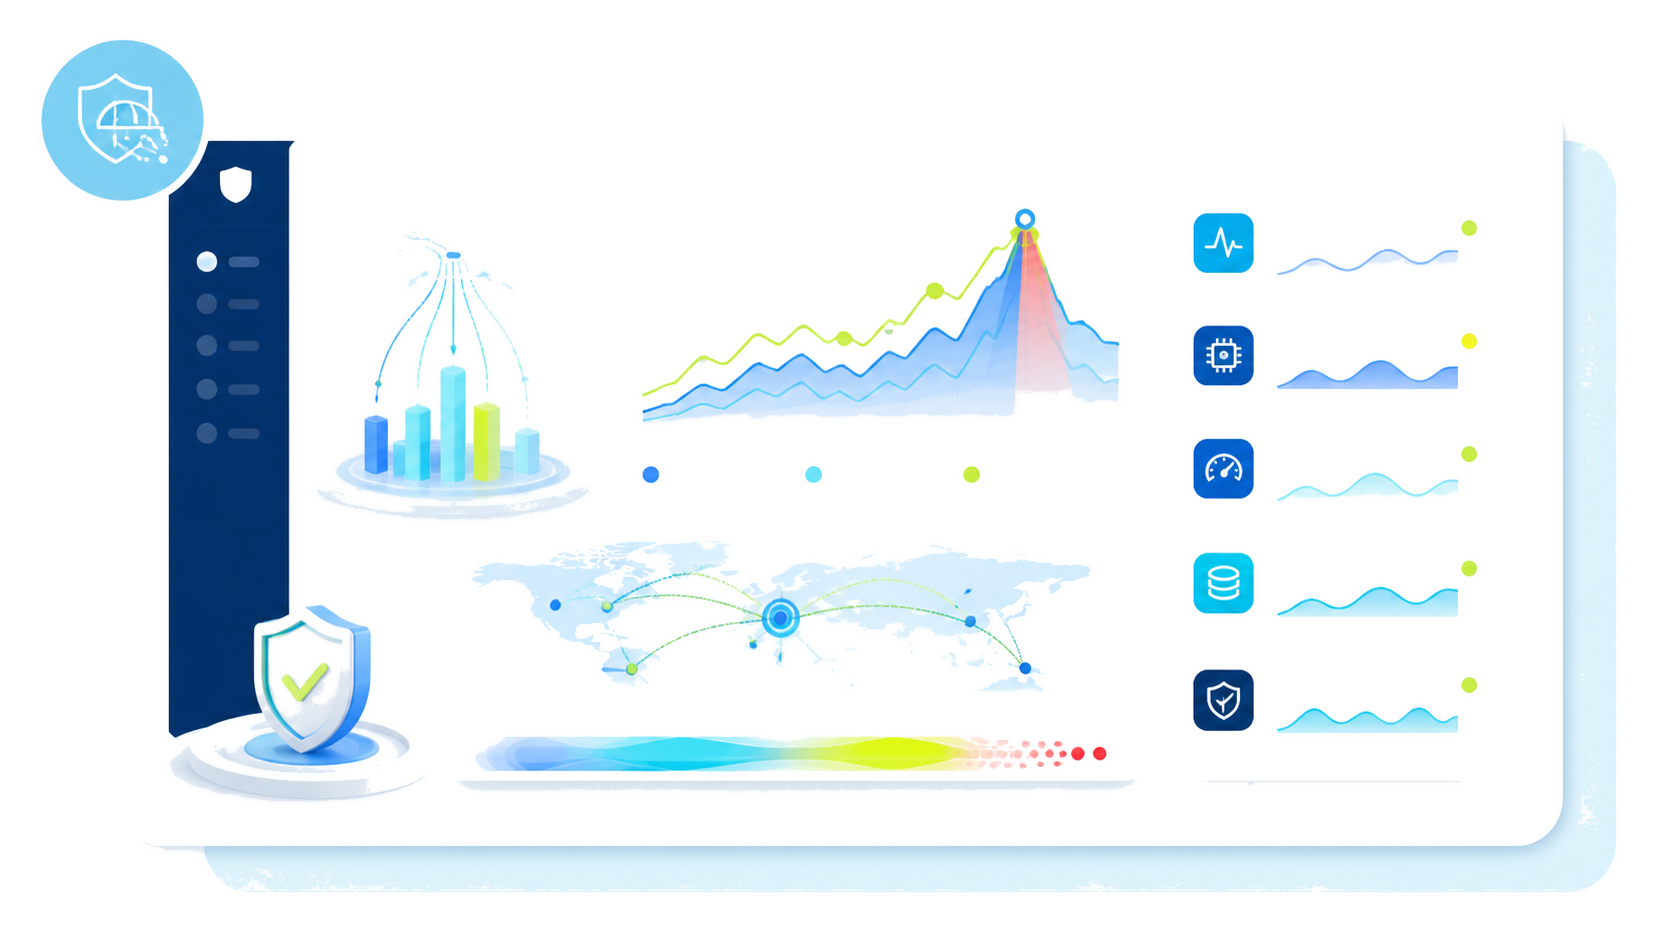
Leed la historia detrás de cada pico de tráfico repentino. La tasa de peticiones, la CPU, la latencia y la forma del tráfico proporcionan la profundidad técnica necesaria para detectar usuarios reales, fallos o actividad hostil. Para gestionar un pico de tráfico sin tiempo de inactividad, distribuid el tráfico entrante, añadid capacidad, utilizad almacenamiento en caché y aplicad la optimización de bases de datos. La protección anti-DDoS aborda los flujos maliciosos. Esta comprensión ayuda a gestionar los picos de tráfico, prevenir el tiempo de inactividad del sitio web bajo un tráfico elevado y evitar bloqueos o un bloqueo innecesario por un escalado inadecuado.
[object Object]

Salvaguardas medibles para picos de tráfico

Obtenga un 99,99% de SLA en computación y equilibrio de carga, además de protección Anti-DDoS de hasta 10 Tbps
Compromiso de servicio de SLA del 99,99%
Compromiso de servicio del 99,99%
Protección de mitigación anti-DDoS
Mitigación incluida
Límites de capacidad de carga
Límites de carga publicados

Construya resiliencia en el enrutamiento, la computación y los datos

Mantenga las solicitudes en movimiento en el punto de entrada

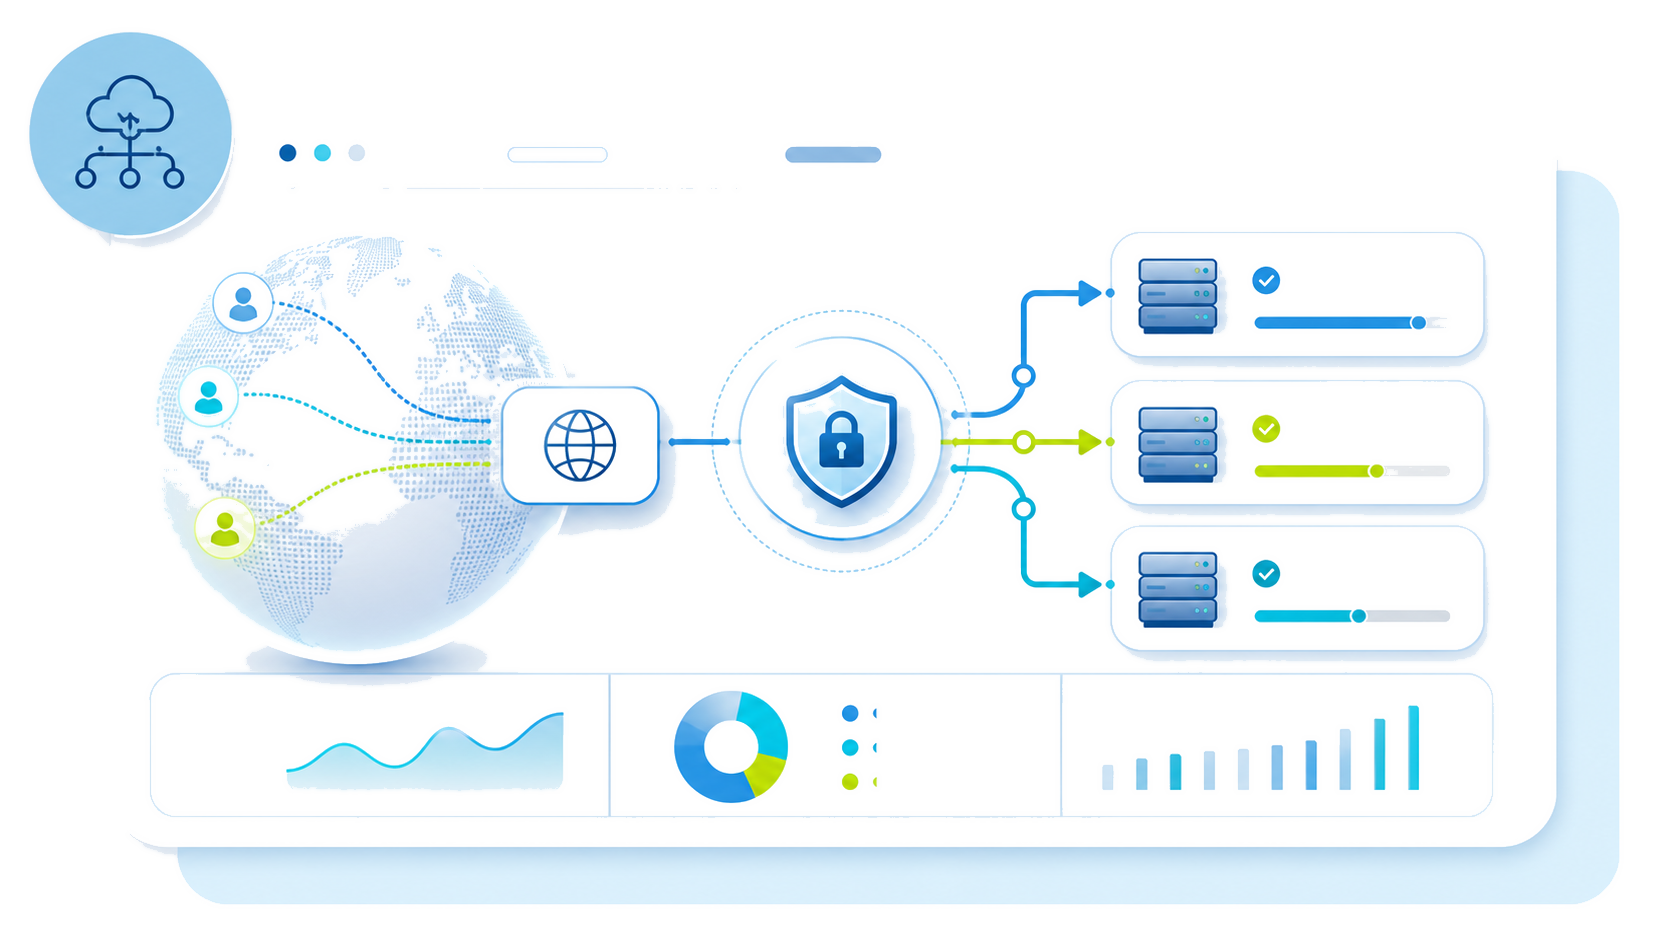
El equilibrador de carga gestionado comprueba el estado del backend, termina TLS y utiliza el enrutamiento ponderado para controlar la entrega de solicitudes. Si un servidor deja de estar saludable, la conmutación por error automática redirige a los usuarios a los nodos disponibles.

Adapte la capacidad de computación a la demanda observada

Escale un conjunto de instancias de computación Gen3 idénticas detrás de la capa de enrutamiento. Elija la capacidad a partir de patrones de tráfico medidos en lugar de suposiciones, y luego añada nodos en un paso controlado a medida que crece la demanda. Cuando una empresa requiera resiliencia geográfica, despliegue en tres zonas de disponibilidad en París o Milán.

Proteja la base de datos de la carga desplazada

Una capacidad de front-end adicional puede exponer una limitación de la base de datos en lugar de resolverla. Proteja los grupos de conexiones, almacene en caché los datos accedidos adecuados en la memoria e inspeccione las consultas lentas de búsqueda o pago antes de escalar más. Estas comprobaciones identifican posibles cuellos de botella que los nodos de aplicación adicionales no pueden eliminar. La protección contra DDoS aborda el tráfico web hostil, mientras que esta arquitectura en capas gestiona los picos legítimos.

Conserve una dirección de servicio estable a través de cada cambio

OpenStack OctaviaIP flotanteTLS
OpenStack Octavia enruta las solicitudes a backends en buen estado, termina TLS y utiliza una distribución ponderada para evitar que una VM se convierta en el cuello de botella de entrada. Una IP flotante conserva la dirección pública mientras los equipos reemplazan, redimensionan o realizan la conmutación por error de los recursos dentro del plazo requerido.

Seleccionad opciones basadas en mediciones de tráfico y, a continuación, probad el rendimiento en condiciones de ventas flash y eventos mediáticos. Estas estrategias ayudan a gestionar los picos de tráfico sin tiempo de inactividad y a proteger la experiencia del usuario durante todo el periodo de escalado.
[object Object]
Una fecha de lanzamiento conocida da tiempo a los equipos para probar la configuración completa bajo una demanda elevada representativa. Cread instancias de computación temporales a partir de una imagen base reutilizable, validad los recorridos de los clientes y utilizad el equilibrio de carga ponderado para introducir capacidad antes de que lleguen los visitantes. Esta estrategia es eficaz para el comercio estacional, los lanzamientos de entradas y la cobertura mediática programada. Debido a que la infraestructura adicional es temporal, la empresa evita pagar por capacidad estática no utilizada durante los periodos de menor actividad.

La atención repentina requiere una respuesta rápida y medida. Escalad las instancias de computación bajo demanda, validad cada nodo nuevo y distribuid el tráfico entrante entre múltiples servidores en buen estado. Aplicad la limitación de tasa cuando un recurso descendente escaso, como la autenticación, el inventario o el procesamiento de pagos, necesite protección. No expandáis cada dependencia automáticamente: leed la latencia y los indicadores de error para determinar dónde se encuentra la limitación.

El alojamiento de alta disponibilidad requiere protección tanto frente a los cambios en la demanda como frente a los fallos de ubicación. Una arquitectura Multi-AZ reduce la dependencia de una única zona de disponibilidad, mientras que la capacidad estática proporciona un margen inmediato para las fluctuaciones habituales. Los equipos pueden entonces añadir recursos rápidamente cuando las condiciones superan esa línea base. Una vez que el tráfico se normalice, confirmad que las colas, la latencia y los errores permanecen estables antes de eliminar los nodos temporales.
Una fecha de lanzamiento conocida da tiempo a los equipos para probar la configuración completa bajo una demanda elevada representativa. Cread instancias de computación temporales a partir de una imagen base reutilizable, validad los recorridos de los clientes y utilizad el equilibrio de carga ponderado para introducir capacidad antes de que lleguen los visitantes. Esta estrategia es eficaz para el comercio estacional, los lanzamientos de entradas y la cobertura mediática programada. Debido a que la infraestructura adicional es temporal, la empresa evita pagar por capacidad estática no utilizada durante los periodos de menor actividad.

Haced que cada respuesta ante un aumento sea repetible

Línea base de capacidad

Realizad pruebas de carga en los principales recorridos de usuario y registrad dónde se sobrecarga el rendimiento de la computación, la red o la base de datos. Esta línea base respalda un plan realista basado en la demanda actual.

Compilación reutilizable

Mantened una instantánea de instancia probada o una imagen dorada. Cada nodo nuevo puede entonces compartir la misma configuración de aplicación, seguridad y red.

Visibilidad operativa

Implementad la monitorización antes de un evento para el volumen de solicitudes, la latencia, los errores, la CPU, las conexiones y los datos accedidos con frecuencia. Las alertas ayudan a los equipos a responder más rápido ante una demanda inesperada.

Madurez de escalado

Utilizad la expansión de máquinas virtuales mediante scripts para gestionar los picos de tráfico o un aumento impulsado por las redes sociales.

Desplegad la protección contra aumentos a través de cuatro flujos de trabajo

Establecer una línea base y proteger

Cuantificad el tráfico esperado y repentino, definid los objetivos de servicio y realizad pruebas de carga en las rutas críticas. Confirmad que la mitigación de ataques esté activa para que los equipos puedan gestionar el aumento de la demanda sin confundir la actividad hostil con un crecimiento legítimo.

Construir y automatizar

Describe la configuración de la flota, la red y el equilibrio con Terraform. El código de infraestructura repetible ayuda a los ingenieros a añadir capacidad de forma coherente en cuestión de minutos u horas, en lugar de reconstruir los servidores manualmente durante un incidente.

Validar los datos y la experiencia

Probad las conexiones a la base de datos, las tasas de error y los tiempos de carga bajo un mayor tráfico. Incluid fallos de nodos y zonas para confirmar que la arquitectura mantiene una experiencia de usuario fluida cuando los componentes individuales dejan de estar disponibles.

Operar y recuperar

Documentad los disparadores de escalado, las rutas de aprobación y contacto, la guía de reversión y la propiedad. Definid cuándo es seguro eliminar la capacidad temporal tras un momento viral, basándoos en la estabilidad de la salud del servicio en lugar de en la primera caída del tráfico.

Eliminad la capacidad temporal cuando el rendimiento se estabilice
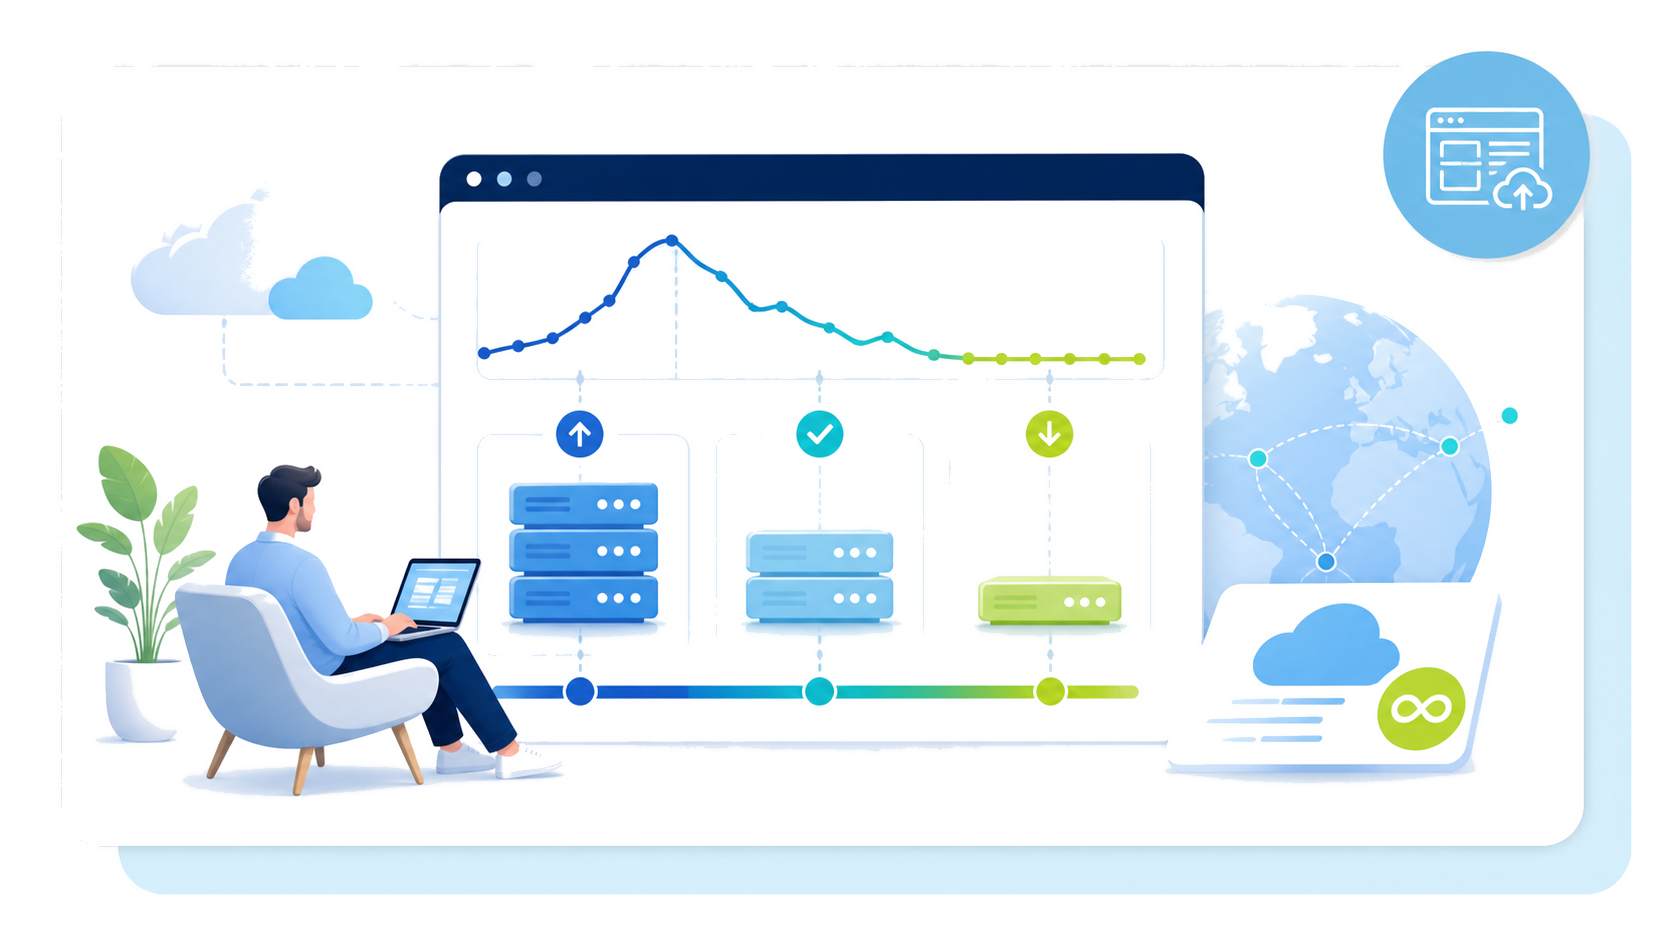
La facturación por segundo de las instancias de computación, con un mínimo de 60 segundos a partir de mayo de 2026, alinea la capacidad temporal con cada pico. Observad cuándo vuelve a la normalidad la demanda de la aplicación, se vacía la cola de solicitudes y se estabiliza la velocidad del servicio antes de eliminar los nodos excedentes de forma eficiente. Este enfoque medido ayuda a garantizar el control de costes sin arriesgarse a sufrir caídas. El tráfico de salida ilimitado y sin medición en la mayoría de las regiones puede reducir la incertidumbre innecesaria para el alojamiento en la nube con gran cantidad de contenido; verificad la disponibilidad regional y las condiciones para vuestro negocio.
[object Object]
Preparad vuestra infraestructura antes del próximo aumento
Iniciad una prueba de Public Cloud o activad un equilibrador de carga gestionado. Desplegad, probad y refinad vuestra respuesta antes de que aumente la demanda.
Activad el equilibrador de carga