Bare Metal GPU de alto rendimiento
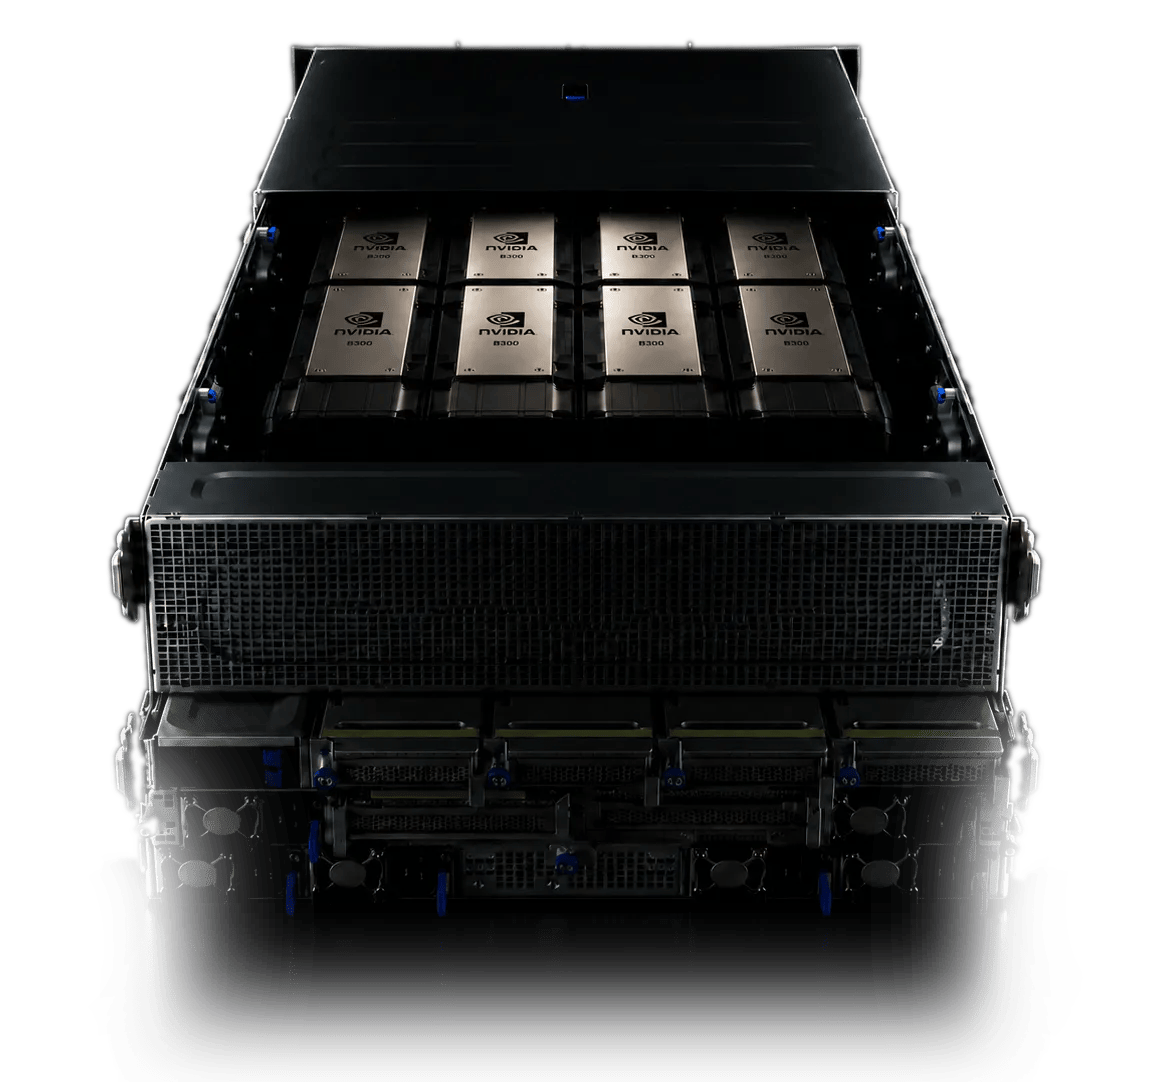
Un nodo NVIDIA HGX B300 completo, en bare metal
8 GPU Blackwell Ultra, 2,1 TB de HBM3e y NVLink 5, sin hipervisor ni recursos compartidos. Acceso root y libertad para elegir el sistema operativo y la versión del driver CUDA: tienes el control total del stack para entrenar, hacer fine-tuning y desplegar tus modelos más grandes.
Compromiso mínimo de 12 meses
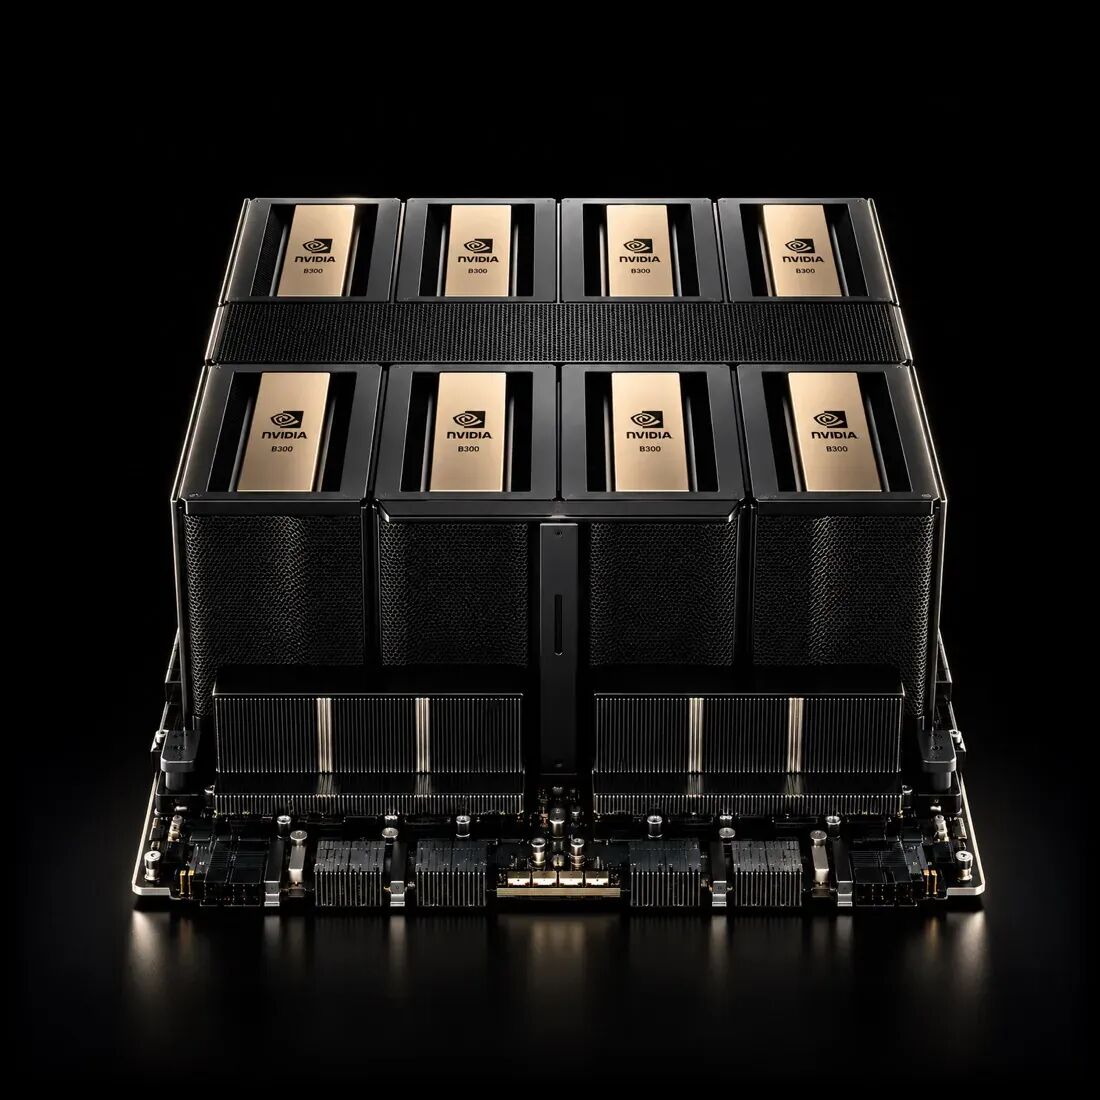
8 GPU Blackwell Ultra: qué cambia respecto a la B200
La B300 frente a las GPU de referencia
Elige una GPU: cada tarjeta muestra la diferencia con la B300.
Cálculo de IAFP8 denso, PFLOPS
Memoria GPUGB
Ancho de banda en memoriaTB/s
- Por servidor HGR-AI-B3008 GPU B300
- 36 PFLOPS FP8
- 2,1 TB de HBM3e
- 64 TB/s de ancho de banda
Datos del fabricante NVIDIA, por GPU, rendimiento máximo sin dispersión. H100 y H200 en versión SXM, RTX PRO 6000 Blackwell Server Edition (FP8 denso estimado).
Características del HGR-AI-B300
| Componente | Característica | HGR-AI-B300 |
|---|---|---|
| GPU8× NVIDIA B300 | Modelo | 8× NVIDIA HGX B300 SXM6Arquitectura Blackwell Ultra |
| Memoria GPU | 2,1 TB de HBM3e262 GB por GPU | |
| Ancho de banda en memoria | 64 TB/s8 TB/s por GPU | |
| Cálculo FP4 (denso) | 108 PFLOPS13,5 PFLOPS por GPU | |
| Cálculo FP8 (denso) | 36 PFLOPS4,5 PFLOPS por GPU | |
| Cálculo BF16 (denso) | 18 PFLOPS2,25 PFLOPS por GPU | |
| Interconexión GPU | NVLink de 5.ª generación1,8 TB/s por GPU, 14,4 TB/s en total | |
| CPU2× Intel Xeon 6 | Procesadores | 2× Intel Xeon 6776PIntel Xeon 6, Granite Rapids |
| Cores/Threads | 128 cores/256 threads2× 64 cores | |
| Frecuencia | 2,3 GHz / 3,9 GHzBase/turbo; 3,6 GHz en todos los núcleos, hasta 4,6 GHz con Priority Core Turbo (8 núcleos) | |
| Caché L3 | 336 MB | |
| TDP | 350 W por CPUSin limitación térmica | |
| RAM2 TB DDR5 | Capacidad | 2 TB DDR5 ECC |
| Frecuencia | 6 400 MHz | |
| Almacenamiento38,4 TB de datos | Sistema | 3× 3,84 TB NVMe PCIe 5.0 |
| Datos | 5× 7,68 TB NVMe PCIe 5.0Formato E1.S, 38,4 TB en total | |
| Red y ancho de bandaHasta 200 Gb/s privados | Ancho de banda público | 10 Gb/s garantizados, ilimitadosOpciones de 15, 20 o 25 Gb/s |
| Ancho de banda privado | 100 Gb/s garantizados, ilimitados2 interfaces 100GbE NVIDIA ConnectX-6 Dx | |
| Link Aggregation | Hasta 200 Gb/s privadosOVHcloud Link Aggregation en las 2 interfaces |
GPU: datos del fabricante NVIDIA, rendimiento máximo sin dispersión. Configuración de hardware fija; solo se puede ajustar el ancho de banda público.
Habla con un experto sobre el HGR-AI-B300
Escribe aquí tus datos y nuestro equipo te contactará para analizar tu proyecto.