Construya un pipeline de eventos en tiempo real para millones de eventos
Los dos cuellos de botella de un pipeline de eventos en tiempo real
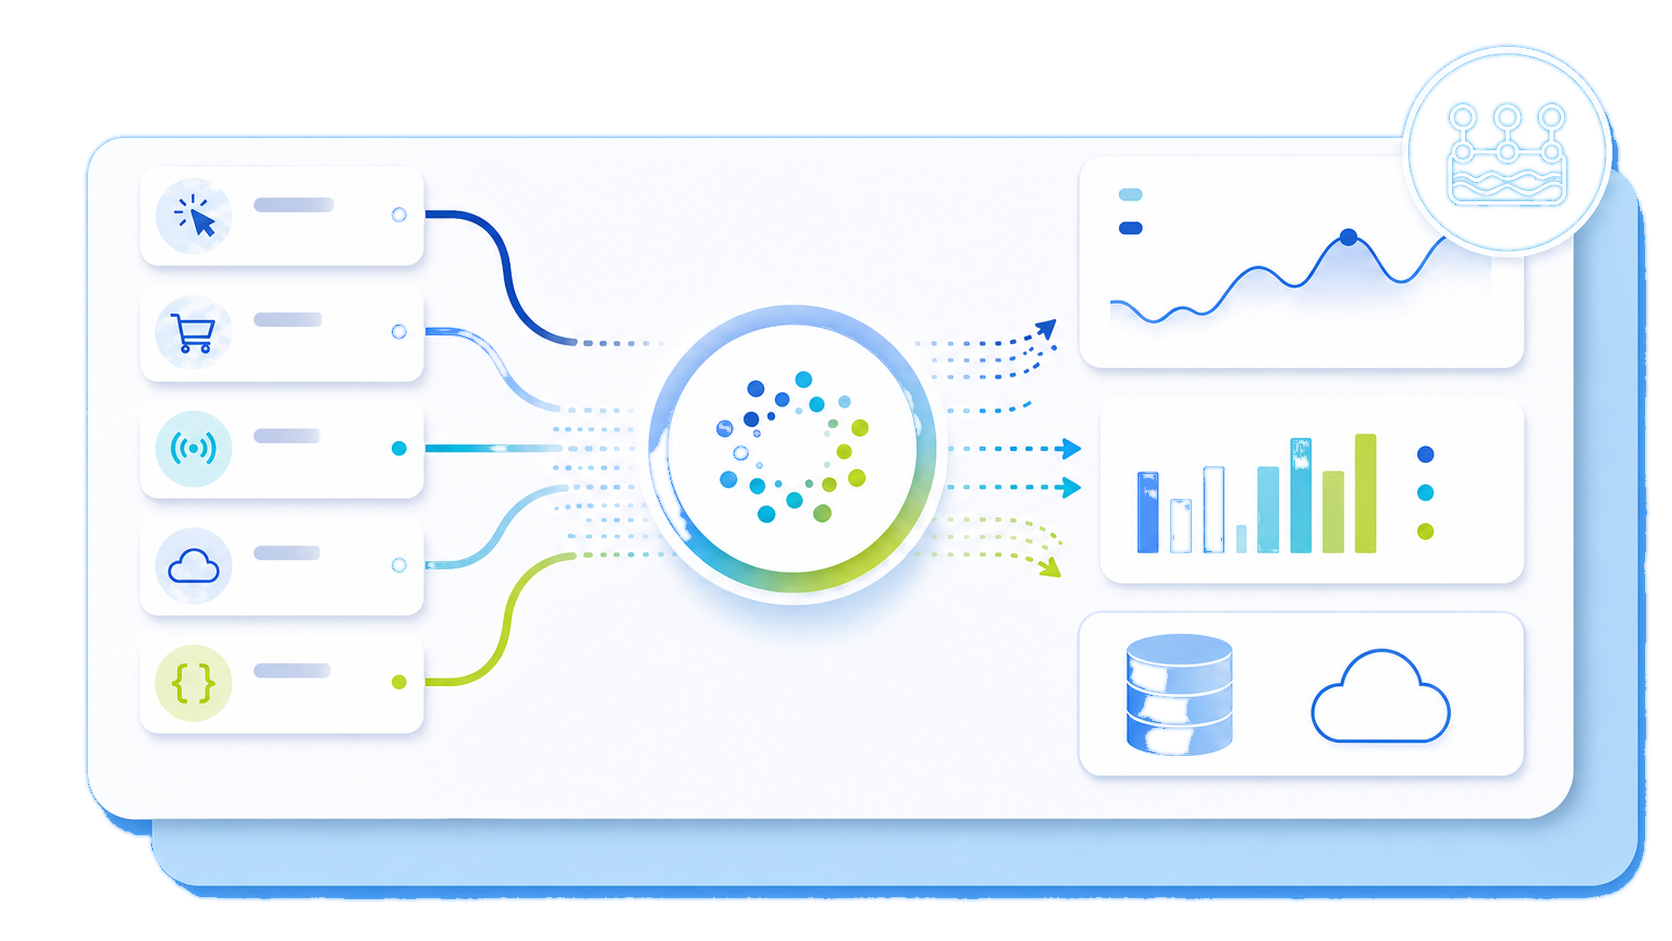
Sin una columna vertebral de streaming duradera, los productores y consumidores de datos distribuidos quedan estrechamente acoplados. Los productores son las aplicaciones que generan y envían eventos a los temas de Kafka, mientras que los consumidores son los servicios que leen dichos eventos. Los productores escriben directamente en colas, bases de datos o servicios personalizados, y cuando un consumidor se cae o se ralentiza, el productor se bloquea o empieza a descartar eventos.
Además, PostgreSQL y bases de datos OLTP de la Public Cloud similares están diseñadas para operaciones a nivel de fila: inserciones, actualizaciones y eliminaciones. No están diseñadas para escanear miles de millones de filas, agregar datos en múltiples dimensiones o actualizar paneles de control cada minuto. A medida que aumenta el volumen de eventos, las consultas que antes devolvían resultados en 200 ms empiezan a tardar segundos, luego decenas de segundos y, finalmente, minutos. El sistema se convierte en un cuello de botella para las decisiones de producto.
Opere con confianza a escala empresarial

Una arquitectura de referencia: Apache Kafka + ClickHouse
Apache Kafka como columna vertebral de streaming
Kafka actúa como el sistema nervioso central para los eventos. Los productores escriben eventos en temas, que están ordenados lógicamente y particionados entre los brokers. Cada partición puede consumirse de forma independiente, que es como Kafka escala la velocidad horizontalmente. Los grupos de consumidores leen de estas particiones, y cada consumidor en un grupo es responsable de un subconjunto de las particiones.
Las particiones son la clave de la velocidad. Un tema con más particiones puede gestionar más escrituras y más consumidores en paralelo, hasta el número de particiones. Los grupos de consumidores permiten la replicación. Los esquemas para las aplicaciones se gestionan normalmente por separado, a menudo con un registro de esquemas, para que los productores y consumidores puedan evolucionar sin romper la compatibilidad entre sí. Los eventos se conservan durante un periodo de retención configurable, lo que le da una ventana para reproducir datos sin tener que reprocesar desde la fuente. Esta durabilidad y desacoplamiento continuo es lo que hace de Kafka una columna vertebral fiable para flujos de eventos de gran volumen.
ClickHouse como capa OLAP en tiempo real
ClickHouse es una base de datos distribuida y columnar diseñada para cargas de trabajo analíticas. Almacena los datos por columna en lugar de por fila, lo que significa que puede omitir columnas irrelevantes durante las consultas y comprimir los datos intensamente. Combinado con su motor de almacenamiento, optimizado para lecturas secuenciales y el filtrado de predicados, esto permite a ClickHouse escanear miles de millones de filas rápidamente y devolver resultados agregados en milisegundos. Los nuevos eventos pueden ingerirse en tiempo real, y ClickHouse puede agregarlos previamente utilizando vistas materializadas que se actualizan a medida que llegan los datos. Esto significa paneles y alertas continuos, sin esperar a un trabajo por lotes o a una ventana de ETL. La base de datos está diseñada para escalar horizontalmente, añadiendo nodos para aumentar la capacidad de almacenamiento y computación a medida que crece el volumen de eventos.
Object Storage como nivel de datos fríos multinivel para eventos antiguos
No todos los datos necesitan residir en almacenamiento en caliente; mantener cada evento en ClickHouse en discos locales se vuelve costoso e innecesario. El patrón común es trasladar los datos más antiguos a Object Storage de OVHcloud (compatible con S3)*, mientras se mantienen los datos recientes en ClickHouse para consultas rápidas. Los eventos anteriores a un umbral configurado se consultan bajo demanda cuando se necesita un análisis histórico más profundo. Este enfoque reduce el coste de la retención a largo plazo mientras preserva la capacidad de ejecutar consultas en todo el conjunto de datos.
Para muchos casos de uso de procesamiento real, la capa activa (ClickHouse) mantiene días o semanas de datos para paneles de control y alertas en tiempo real, mientras que la capa fría (Object Storage de OVHcloud) mantiene meses o años de historial para cumplimiento, auditorías y análisis profundos periódicos. Esta separación mantiene el coste operativo predecible y permite que el pipeline escale sin alcanzar un límite estricto de almacenamiento de aplicaciones.
La integración nativa del motor Kafka en ClickHouse
ClickHouse tiene un motor de tabla Kafka integrado que le permite suscribirse directamente a los temas de Kafka. Usted define una tabla con el motor Kafka, especifica el nombre del tema, la lista de intermediarios y el grupo de consumidores, y ClickHouse comienza a consumir eventos de Kafka como si fueran filas en una tabla normal. Esta es una integración directa y nativa que no requiere middleware adicional. El motor Kafka en ClickHouse está diseñado para la ingesta de streaming. Lee registros del tema, los analiza según el formato que especifique (JSON, Avro, Protobuf, etc.) y los muestra como filas que pueden consultarse o insertarse en otras tablas.
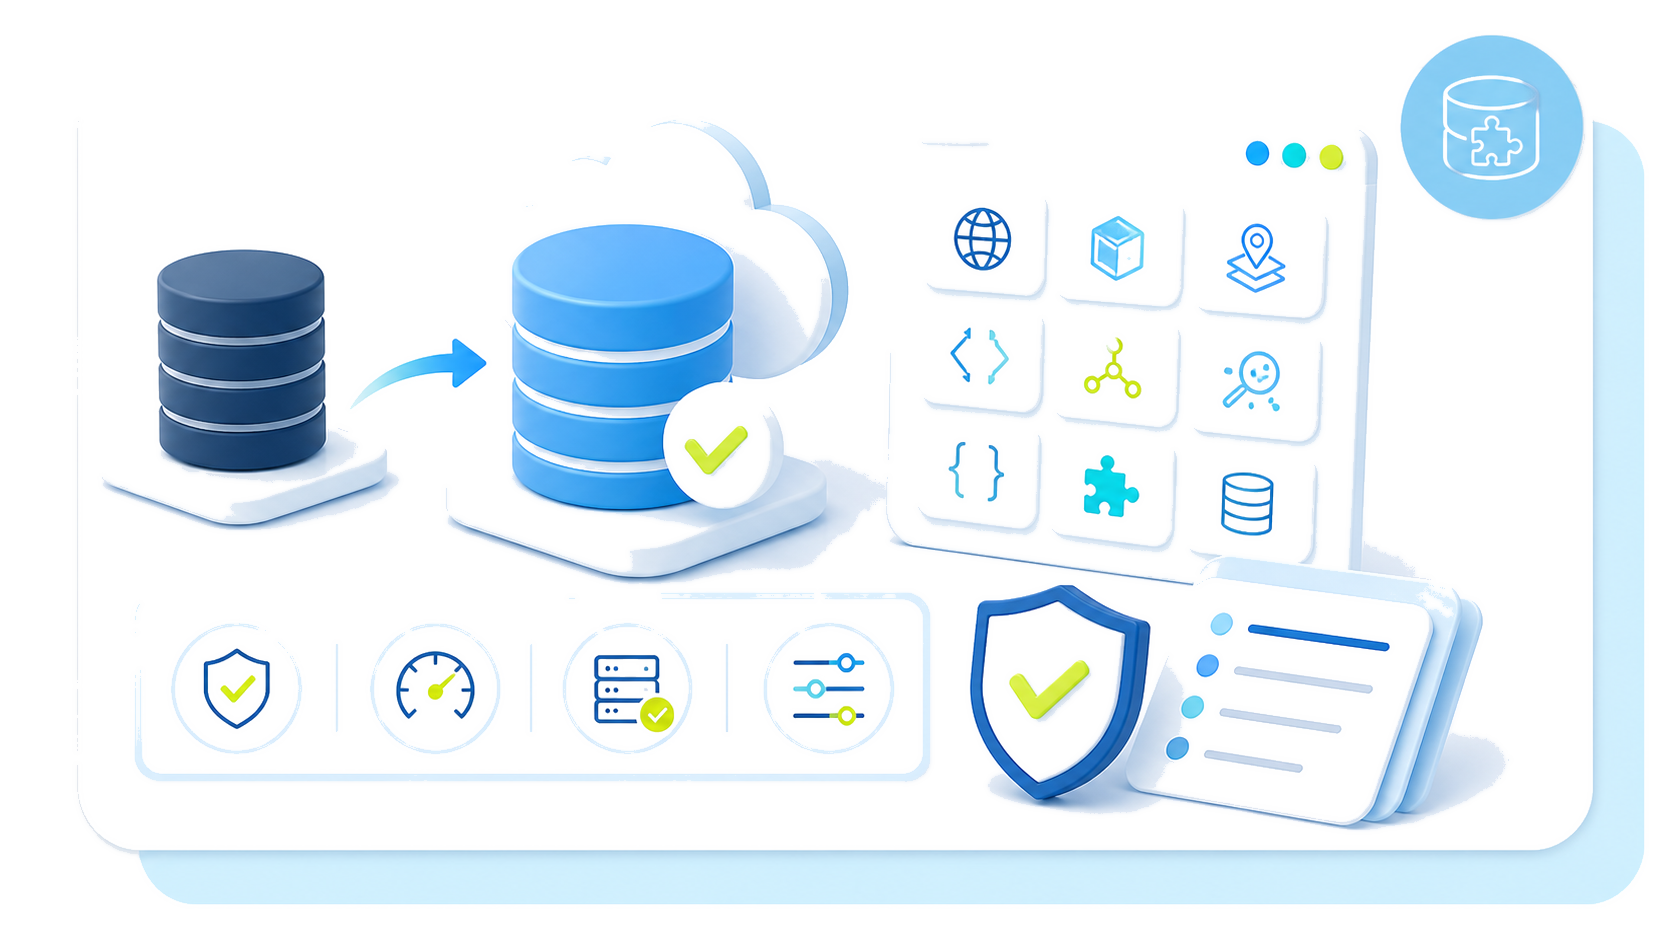
Modele los eventos entrantes para tomar decisiones más rápidas
Agregue previamente medidas recurrentes
Las vistas materializadas calculan continuamente totales, tasas y métricas agrupadas a medida que llegan los eventos, reduciendo el trabajo repetido en el momento de la consulta.
Alinee las tablas con los patrones de acceso
Ordene los datos por tiempo y dimensiones filtradas habitualmente para que las investigaciones lean menos registros irrelevantes.
Lea solo los campos útiles
La selección de columnas limita el escaneo a los atributos requeridos por cada panel de control, alerta o consulta exploratoria.
Diseñe la retención en torno a la demanda
Separe los registros consultados frecuentemente de los datos menos activos. Las tablas con retención consciente ayudan a mantener análisis de menos de un segundo para vistas operativas, a la vez que mantienen las investigaciones prácticas a medida que crecen los historiales.
El coste de la espera
Asigne a cada capa una responsabilidad clara
Columna vertebral de streaming
Busque, ordene y reproduzca pipelines de eventos de gran volumen para que los productores permanezcan independientes de las cargas de trabajo analíticas y de procesamiento.
Servicio analítico
Exponga eventos recientes a consultas operativas rápidas, paneles de control e investigaciones mientras mantiene un entorno dedicado para la demanda analítica.
Nivel de datos fríos
Conserve el historial más antiguo fuera del almacenamiento centrado en el rendimiento. Esta separación permite el acceso a largo plazo sin mantener cada evento en la ruta analítica activa. El patrón común es clasificar los datos más antiguos en OVHcloud Object Storage
Operaciones y entrega gestionadas
OVHcloud gestiona la replicación, las copias de seguridad y la monitorización en toda la arquitectura del servicio. Los equipos pueden desplegar recursos a través del Panel de Control de OVHcloud o definir entornos repetibles con Terraform.
Despliegue un pipeline de eventos en tiempo real en minutos
Para los equipos que deseen ayuda para dimensionar el stack, OVHcloud ofrece acceso directo a especialistas en infraestructura de datos, incluso para las Databases for PostgreSQL gestionadas, que pueden evaluar sus volúmenes de eventos y patrones de consulta actuales y proporcionar una comparación de costes con respecto a su stack existente. Tanto si es un ingeniero de datos que necesita resultados en tiempo real de miles de millones de filas con un tiempo de infraestructura mínimo, como si es un responsable de datos que desea una carga operativa reducida y costes de nube predecibles, el stack gestionado elimina la carga operativa manteniendo la arquitectura portátil y de código abierto.
*S3 es una marca registrada de Amazon Technologies, Inc. Los servicios de OVHcloud no están patrocinados ni aprobados por Amazon Technologies, Inc., ni están afiliados a ella de ninguna manera.
Explore nuestros servicios de streaming, análisis y almacenamiento, y convierta eventos de gran volumen en información fiable y consultable, reduciendo al mismo tiempo el trabajo operativo necesario para ejecutar la infraestructura subyacente.