Bouw een realtime event-pipeline voor miljoenen gebeurtenissen
De twee knelpunten van een realtime event-pipeline
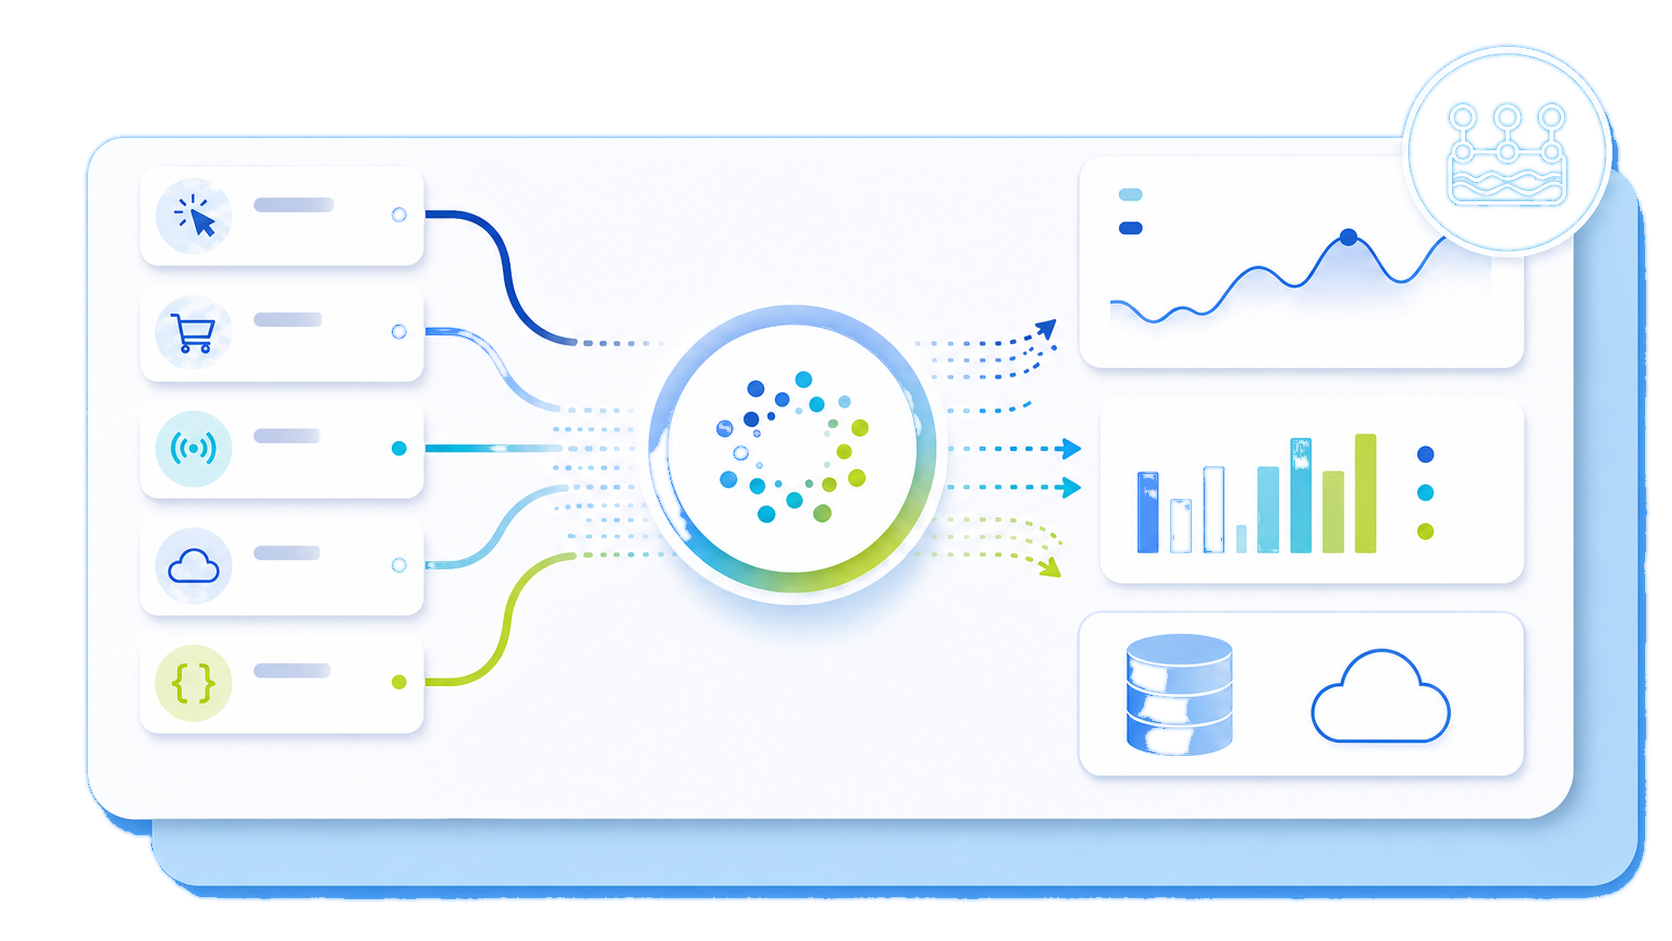
Zonder een duurzame streaming-backbone raken gedistribueerde dataproducenten en dataconsumenten nauw met elkaar verbonden. Producenten zijn de applicaties die gebeurtenissen genereren en naar Kafka-topics sturen, terwijl consumenten de diensten zijn die die gebeurtenissen lezen. Producenten schrijven rechtstreeks naar wachtrijen, databases of aangepaste diensten, en wanneer een consument uitvalt of achterblijft, blokkeert de producent of begint deze gebeurtenissen te verliezen.
Bovendien zijn PostgreSQL en vergelijkbare OLTP Public Cloud-databases ontworpen voor operaties op rijniveau: inserts, updates, verwijderingen. Ze zijn niet ontworpen om miljarden rijen te scannen, over meerdere dimensies te aggregeren of dashboards elke minuut bij te werken. Naarmate het volume aan gebeurtenissen groeit, gaan zoekopdrachten die voorheen binnen 200 ms resultaat gaven, seconden duren, daarna tientallen seconden, en vervolgens minuten. Het systeem wordt een knelpunt voor productbeslissingen.
Werk met vertrouwen op ondernemingsschaal

Een referentiearchitectuur: Apache Kafka + ClickHouse
Apache Kafka als de streaming-backbone
Kafka fungeert als het centrale zenuwstelsel voor gebeurtenissen. Producers schrijven gebeurtenissen naar topics, die logisch geordend en verdeeld zijn over brokers. Elke partitie kan onafhankelijk worden geconsumeerd, wat de manier is waarop Kafka de doorvoer horizontaal schaalt. Consumentengroepen lezen uit deze partities en elke consument in een groep is verantwoordelijk voor een subset van de partities.
Partities zijn de sleutel tot doorvoer. Een topic met meer partities kan meer schrijfacties en meer consumenten parallel verwerken, tot aan het aantal partities. Consumentengroepen maken replay mogelijk. Schema's voor applicaties worden doorgaans afzonderlijk beheerd, vaak met een Schema Registry, zodat producers en consumenten kunnen evolueren zonder elkaar te breken. Gebeurtenissen worden bewaard voor een configureerbare retentieperiode, wat u een venster geeft om gegevens opnieuw af te spelen zonder dat u ze vanaf de bron opnieuw hoeft te verwerken. Deze duurzaamheid en continue ontkoppeling is wat Kafka een betrouwbare backbone maakt voor event-streams met een hoog volume.
ClickHouse als de realtime OLAP-laag
ClickHouse is een kolomgeoriënteerde, gedistribueerde database die is ontworpen voor analytische workloads. Het slaat gegevens op per kolom in plaats van per rij, wat betekent dat het irrelevante kolommen kan overslaan tijdens zoekopdrachten en gegevens sterk kan comprimeren. Gecombineerd met de opslagengine, die is geoptimaliseerd voor sequentiële leesacties en 'predicate pushdown', is ClickHouse in staat om miljarden rijen snel te scannen en geaggregeerde resultaten in milliseconden terug te geven. Nieuwe gebeurtenissen kunnen in realtime worden opgenomen en ClickHouse kan ze vooraf aggregeren met behulp van 'materialized views' die worden bijgewerkt zodra er gegevens binnenkomen. Dit betekent continue dashboards en waarschuwingen, zonder te hoeven wachten op een batch-job of ETL-venster. De database is ontworpen om horizontaal te schalen, waarbij nodes worden toegevoegd om de opslag- en rekenkracht te vergroten naarmate het volume aan gebeurtenissen groeit.
Object Storage als een gelaagde cold-data-laag voor oude gebeurtenissen
Niet alle gegevens hoeven in 'hot storage' te staan; elke gebeurtenis in ClickHouse op lokale schijven bewaren wordt duur en is onnodig. Het gebruikelijke patroon is om oudere gegevens te verplaatsen naar OVHcloud Object Storage (S3-compatibele)* opslag, terwijl recente gegevens in ClickHouse worden bewaard voor snelle query's. Gebeurtenissen die ouder zijn dan een geconfigureerde drempelwaarde worden op aanvraag opgevraagd wanneer diepere historische analyse nodig is. Deze aanpak verlaagt de kosten voor langetermijnretentie en behoudt tegelijkertijd de mogelijkheid om zoekopdrachten uit te voeren op de volledige dataset.
Voor veel realtime verwerkingsscenario's bevat de hot layer (ClickHouse) gegevens van dagen of weken voor dashboards en realtime waarschuwingen, terwijl de cold layer (OVHcloud Object Storage) maanden of jaren aan historie bevat voor compliance, audits en periodieke diepgaande analyses. Deze scheiding houdt de operationele kosten voorspelbaar en stelt de pipeline in staat om te schalen zonder tegen een harde grens voor app-opslag aan te lopen.
De native Kafka-engine-integratie in ClickHouse
ClickHouse heeft een ingebouwde Kafka-tabelengine waarmee u zich direct kunt abonneren op Kafka-topics. U definieert een tabel met de Kafka-engine, specificeert de topicnaam, de lijst met brokers en de consumentengroep, en ClickHouse begint gebeurtenissen uit Kafka te consumeren alsof het rijen in een reguliere tabel zijn. Dit is een directe, native integratie waarvoor geen extra middleware nodig is. De Kafka-engine in ClickHouse is ontworpen voor streaming-ingestie. Deze leest records uit het topic, analyseert ze volgens het formaat dat u opgeeft (JSON, Avro, Protobuf, enz.) en presenteert ze als rijen die kunnen worden opgevraagd of in andere tabellen kunnen worden ingevoegd.
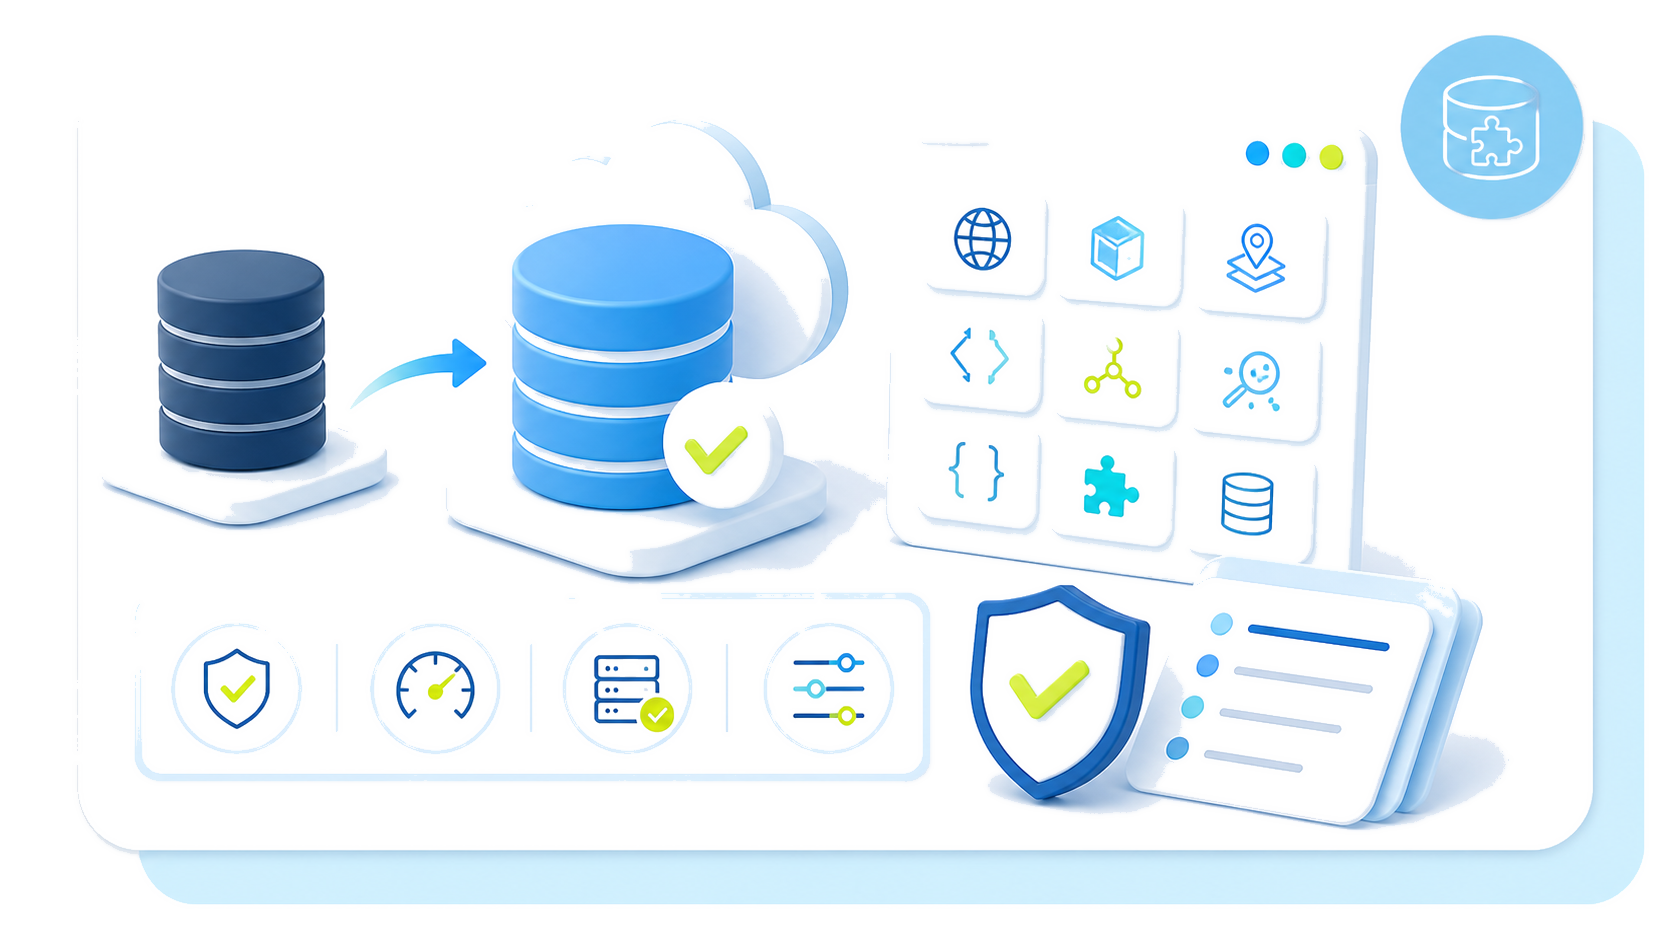
Vorm inkomende gebeurtenissen voor snellere beslissingen
Pre-aggregeer terugkerende metingen
Gerealiseerde weergaven berekenen continu totalen, tarieven en gegroepeerde statistieken zodra gebeurtenissen binnenkomen, waardoor herhaald werk tijdens het uitvoeren van zoekopdrachten wordt verminderd.
Lijn tabellen uit met toegangspatronen
Sorteer gegevens op tijd en veelgebruikte gefilterde dimensies, zodat onderzoeken minder irrelevante records lezen.
Lees alleen nuttige velden
Kolomselectie beperkt het scannen tot de kenmerken die vereist zijn voor elk dashboard, elke waarschuwing of elke verkennende query.
Ontwerp retentie op basis van de vraag
Scheid veelgevraagde records van minder actieve gegevens. Retentiebewuste tabellen helpen bij het behouden van razendsnelle analyses voor operationele weergaven, terwijl onderzoeken praktisch blijven naarmate de geschiedenis groeit.
De kosten van wachten
Wijs aan elke laag een duidelijke verantwoordelijkheid toe
Streaming-backbone
Buffer, orden en speel gebeurtenisstromen met een hoog volume opnieuw af, zodat producenten onafhankelijk blijven van verwerkings- en analytische workloads.
Analytische bediening
Stel recente gebeurtenissen bloot aan snelle operationele query's, dashboards en onderzoeken, terwijl een toegewezen omgeving voor analytische vereisten behouden blijft.
Koude datalaag
Bewaar oudere geschiedenis buiten prestatiegerichte opslag. Deze scheiding ondersteunt langetermijntoegang zonder elke gebeurtenis in het actieve analytische pad te houden. Het algemene patroon is om oudere gegevens in lagen onder te brengen in OVHcloud Object Storage
Beheerde activiteiten & levering
OVHcloud beheert replicatie, back-ups en monitoring in de gehele servicearchitectuur. Teams kunnen resources implementeren via het OVHcloud Control Panel of herhaalbare omgevingen definiëren met Terraform.
Implementeer binnen enkele minuten een realtime event-pipeline
Voor teams die hulp willen bij het dimensioneren van de stack, biedt OVHcloud directe toegang tot data-infrastructuurspecialisten, waaronder voor Managed Databases for PostgreSQL, die uw huidige gebeurtenisvolumes en querypatronen kunnen beoordelen en een kostenvergelijking kunnen maken met uw bestaande stack. Of u nu een Data Engineer bent die realtime resultaten met miljarden rijen nodig heeft met minimale infrastructuurtijd, of een Head of Data die minder operationele load en voorspelbare cloudkosten wil, de beheerde stack verwijdert de operationele overhead terwijl de architectuur draagbaar en open-source blijft.
*S3 is een gedeponeerd handelsmerk van Amazon Technologies, Inc. OVHcloud-diensten worden op geen enkele wijze gesponsord of goedgekeurd door, noch gelieerd aan Amazon Technologies, Inc.
Verken onze streaming-, analytische en opslagdiensten en zet vervolgens gebeurtenissen met een hoog volume om in betrouwbare, doorzoekbare inzichten, terwijl u de operationele wordload voor het draaien van de onderliggende infrastructuur vermindert.