Créez un pipeline d'événements en temps réel pour des millions d'événements
Les deux goulots d'étranglement d'un pipeline d'événements en temps réel
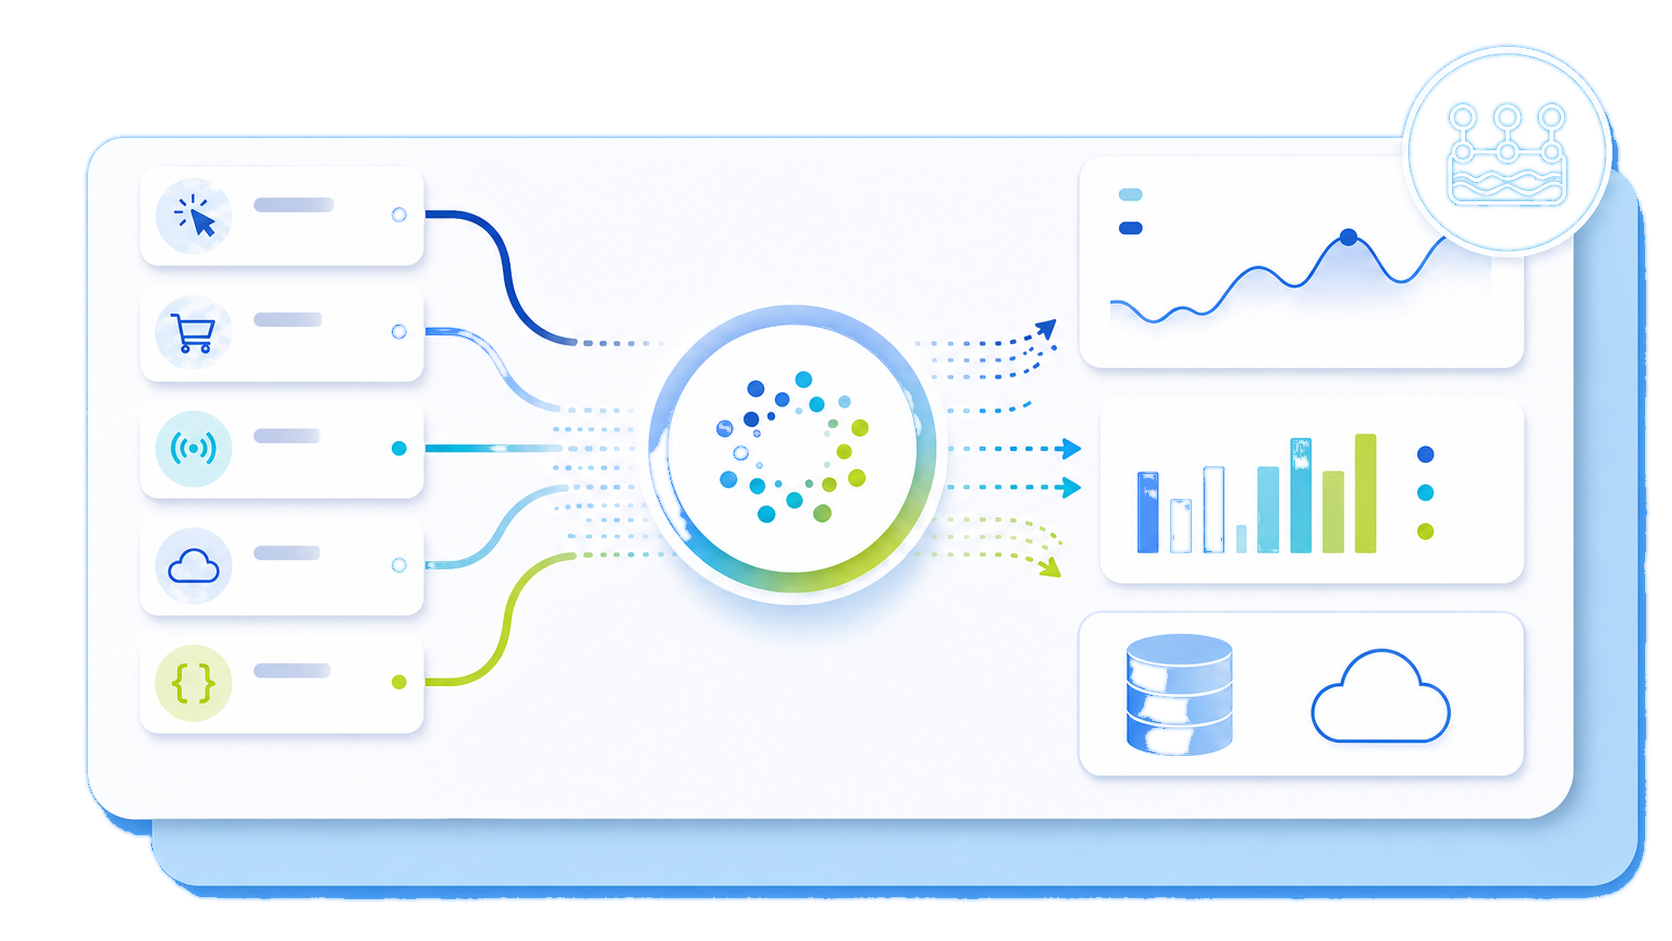
Sans une infrastructure de streaming durable, les producteurs et les consommateurs de données distribués deviennent étroitement associés. Les producteurs sont les applications qui génèrent et envoient des événements dans les topics Kafka, tandis que les consommateurs sont les services qui lisent ces événements. Les producteurs écrivent directement dans des files d'attente, des bases de données ou des services personnalisés, et lorsqu'un consommateur tombe en panne ou accuse une latence, le producteur se bloque ou commence à perdre des événements.
De plus, PostgreSQL et les bases de données Public Cloud OLTP similaires sont conçues pour des opérations au niveau des lignes : insertions, mises à jour, suppressions. Elles ne sont pas conçues pour analyser des milliards de lignes, agréger sur plusieurs dimensions ou mettre à jour des tableaux de bord chaque minute. À mesure que le volume d'événements augmente, les requêtes qui renvoyaient des résultats en 200 ms commencent à prendre des secondes, puis des dizaines de secondes, puis des minutes. Le système se transforme en goulot d'étranglement pour les décisions produit.
Opérez en toute confiance à l'échelle de l'entreprise

Une architecture de référence : Apache Kafka + ClickHouse
Apache Kafka comme infrastructure de streaming
Kafka agit comme le système nerveux central des événements. Les producteurs écrivent des événements dans des topics, qui sont logiquement ordonnés et répartis en partitions sur les brokers. Chaque partition peut être consommée indépendamment, ce qui permet à Kafka de faire évoluer le débit horizontalement. Les groupes de consommateurs lisent à partir de ces partitions, et chaque consommateur dans un groupe est responsable d'un sous-ensemble des partitions.
Les partitions sont la clé du débit. Un topic avec plus de partitions peut gérer plus d'écritures et plus de consommateurs en parallèle, jusqu'au nombre de partitions. Les groupes de consommateurs permettent la relecture. Les schémas pour les applications sont généralement gérés séparément, souvent avec un registre de schémas, afin que les producteurs et les consommateurs puissent évoluer sans se bloquer mutuellement. Les événements sont conservés pendant une période de rétention configurable, ce qui vous donne une fenêtre pour relire les données sans avoir à retraiter depuis la source. Cette durabilité et ce découplage continu sont ce qui fait de Kafka une infrastructure fiable pour les flux d'événements à haut volume.
ClickHouse comme couche OLAP en temps réel
ClickHouse est une base de données distribuée en colonnes conçue pour les charges de travail analytiques. Il stocke les données par colonne et non par ligne, ce qui signifie qu'il peut ignorer les colonnes non pertinentes lors des requêtes et compresser fortement les données. L’association avec son moteur de stockage, optimisé pour les lectures séquentielles et le pushdown des prédicats, permet à ClickHouse de scanner des milliards de lignes rapidement et de renvoyer des résultats agrégés en quelques millisecondes. Les nouveaux événements peuvent être ingérés en temps réel, et ClickHouse peut les pré-agréger en utilisant des vues matérialisées qui se mettent à jour à mesure que les données arrivent. Cela donne des tableaux de bord et des alertes en continu, sans attendre un traitement par lots ou une fenêtre ETL. La base de données est conçue pour évoluer horizontalement, en ajoutant des nœuds pour augmenter la capacité de stockage et de calcul à mesure que le volume d'événements augmente.
Object Storage comme couche de données froides hiérarchisée pour les anciens événements
Toutes les données n'ont pas besoin de résider dans un stockage à chaud ; conserver chaque événement dans ClickHouse sur des disques locaux devient coûteux et inutile. Le modèle courant consiste à déplacer les données plus anciennes vers Object Storage d’OVHcloud (compatible S3)*, tout en conservant les données récentes dans ClickHouse pour des requêtes rapides. Les événements plus anciens qu'un seuil configuré sont interrogés à la demande lorsqu'une analyse historique plus approfondie est nécessaire. Cette approche réduit le coût de la rétention à long terme tout en préservant la capacité d'exécuter des requêtes sur l'ensemble du jeu de données.
Pour de nombreux cas d'usage de traitement réel, la couche chaude (ClickHouse) conserve des jours ou des semaines de données pour les tableaux de bord et les alertes en temps réel, tandis que la couche froide (Object Storage d’OVHcloud) conserve des mois ou des années d'historique pour la conformité, les audits et les analyses approfondies périodiques. Cette séparation permet de maintenir des coûts opérationnels prévisibles et de faire évoluer le pipeline sans atteindre une limite stricte de stockage des applications.
L'intégration native du moteur Kafka dans ClickHouse
ClickHouse dispose d'un moteur de tables Kafka intégré qui vous permet de vous abonner directement aux topics Kafka. Vous définissez une table avec le moteur Kafka, spécifiez le nom du topic, la liste des brokers et le groupe de consommateurs, et ClickHouse commence à consommer les événements de Kafka comme s'il s'agissait de lignes dans une table classique. Il s'agit d'une intégration directe et native qui ne nécessite aucun intergiciel supplémentaire. Le moteur Kafka dans ClickHouse est conçu pour l'ingestion en continu. Il lit les enregistrements du topic, les analyse selon le format que vous spécifiez (JSON, Avro, Protobuf, etc.) et les présente sous forme de lignes pouvant être interrogées ou insérées dans d'autres tables.
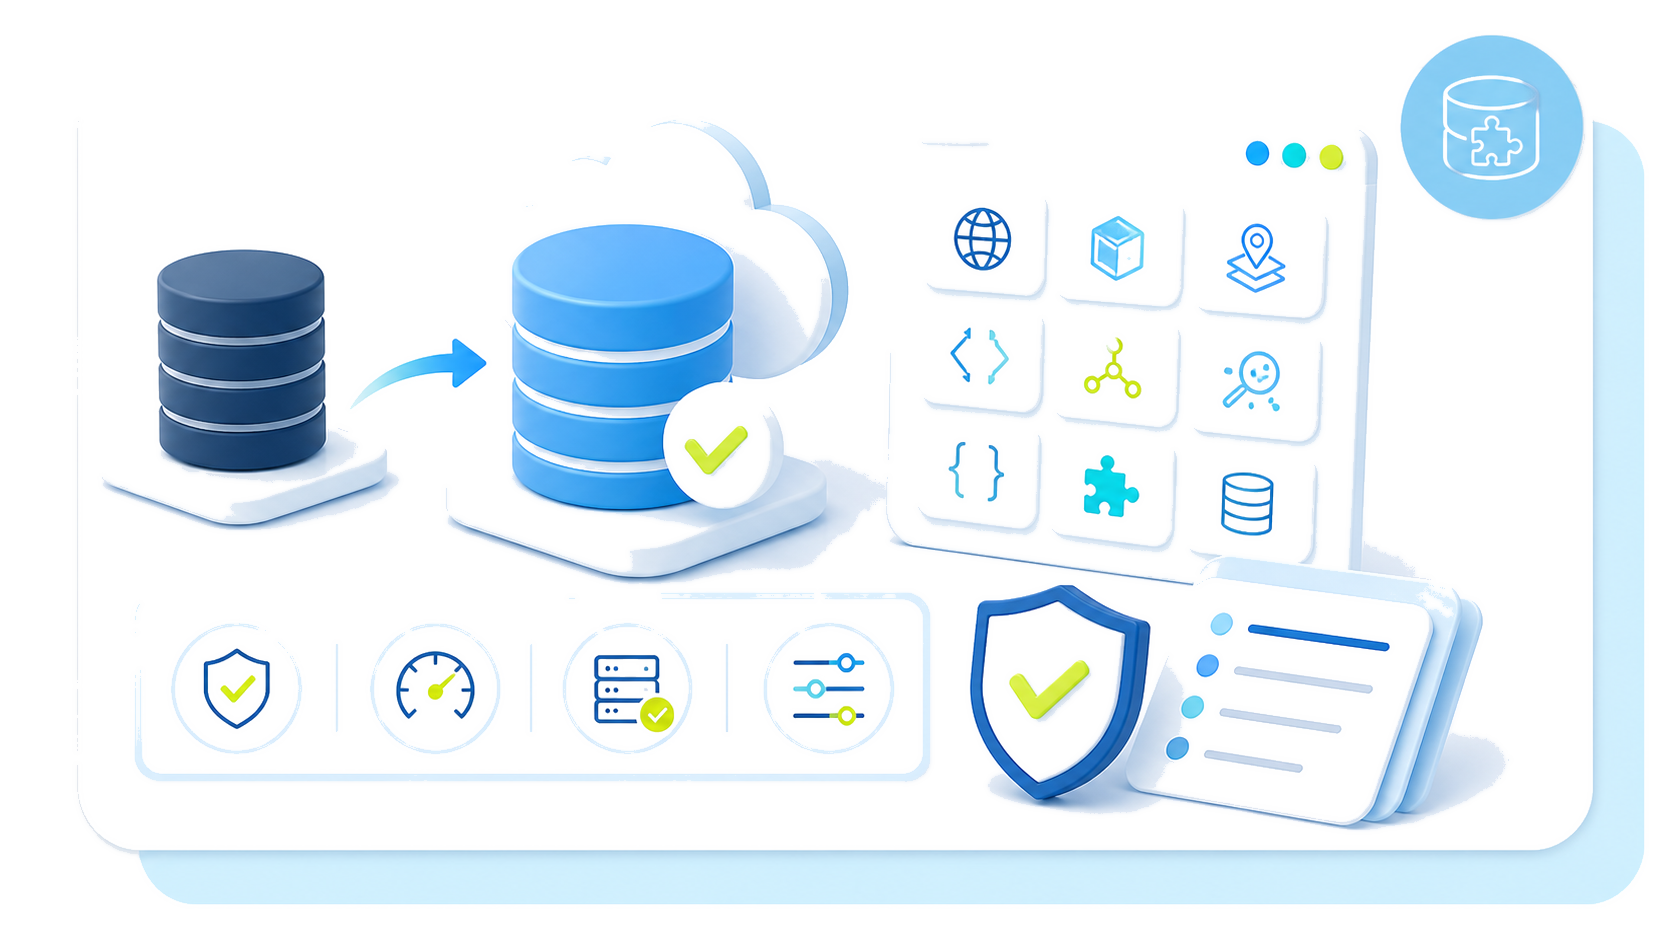
Façonnez les événements entrants pour des décisions plus rapides
Pré-agréger les mesures récurrentes
Les vues matérialisées calculent en continu les totaux, les taux et les métriques groupées à mesure que les événements arrivent, réduisant ainsi le travail répété au moment de la requête.
Aligner les tables sur les modèles d'accès
Triez les données par temps et par dimensions fréquemment filtrées afin que les investigations relèvent moins d'enregistrements non pertinents.
Ne lire que les champs utiles
La sélection de colonnes limite l'analyse aux attributs requis par chaque tableau de bord, alerte ou requête exploratoire.
Concevoir la rétention en fonction de la demande
Séparez les enregistrements fréquemment interrogés des données moins actives. Les tables prenant en compte la rétention aident à maintenir des analyses en moins d'une seconde pour les vues opérationnelles tout en gardant les investigations pratiques à mesure que les historiques augmentent.
Le coût de l'attente
Attribuez à chaque couche une responsabilité claire
Infrastructure de streaming
Mettez en tampon, ordonnancez et rejouez les flux d'événements à haut volume afin que les producteurs restent indépendants des charges de travail de traitement et d'analyse.
Service analytique
Exposez les événements récents aux requêtes opérationnelles rapides, aux tableaux de bord et aux investigations tout en maintenant un environnement dédié pour la demande analytique.
Couche de données froides
Conservez l'historique plus ancien en dehors du stockage axé sur la performance. Cette séparation prend en charge l'accès à long terme sans conserver chaque événement dans le chemin analytique chaud. Le modèle courant consiste à hiérarchiser les données plus anciennes dans Object Storage d’OVHcloud
Opérations et livraison gérées
OVHcloud gère la réplication, les sauvegardes et la surveillance sur l'ensemble de l'architecture de service. Les équipes peuvent déployer des ressources via le panneau de commande OVHcloud ou définir des environnements reproductibles avec Terraform.
Déployer un pipeline d'événements en temps réel en quelques minutes
Pour les équipes qui souhaitent obtenir de l'aide pour dimensionner la pile, OVHcloud offre un accès direct à des spécialistes de l'infrastructure de données, notamment pour les bases de données gérées pour PostgreSQL, qui peuvent évaluer vos volumes d'événements et vos modèles de requêtes actuels et fournir une comparaison des coûts par rapport à votre pile existante. Que vous soyez un ingénieur de données ayant besoin de résultats en temps réel sur des milliards de lignes avec un temps d'infrastructure minimal, ou un responsable des données souhaitant réduire la charge opérationnelle et prévoir les coûts cloud, la pile gérée supprime la surcharge opérationnelle tout en gardant l'architecture portable et open source.
* S3 est une marque déposée d'Amazon Technologies, Inc. Les services OVHcloud ne sont ni sponsorisés, ni approuvés par, ni affiliés à Amazon Technologies, Inc. de quelque manière que ce soit.
Découvrez nos services de streaming, d'analyse et de stockage, puis transformez des événements à haut volume en informations fiables et interrogeables tout en réduisant le travail opérationnel requis pour exécuter l'infrastructure sous-jacente.