Infra as a Service

Gérez les pics de trafic sans interruption et adaptez votre capacité en quelques minutes
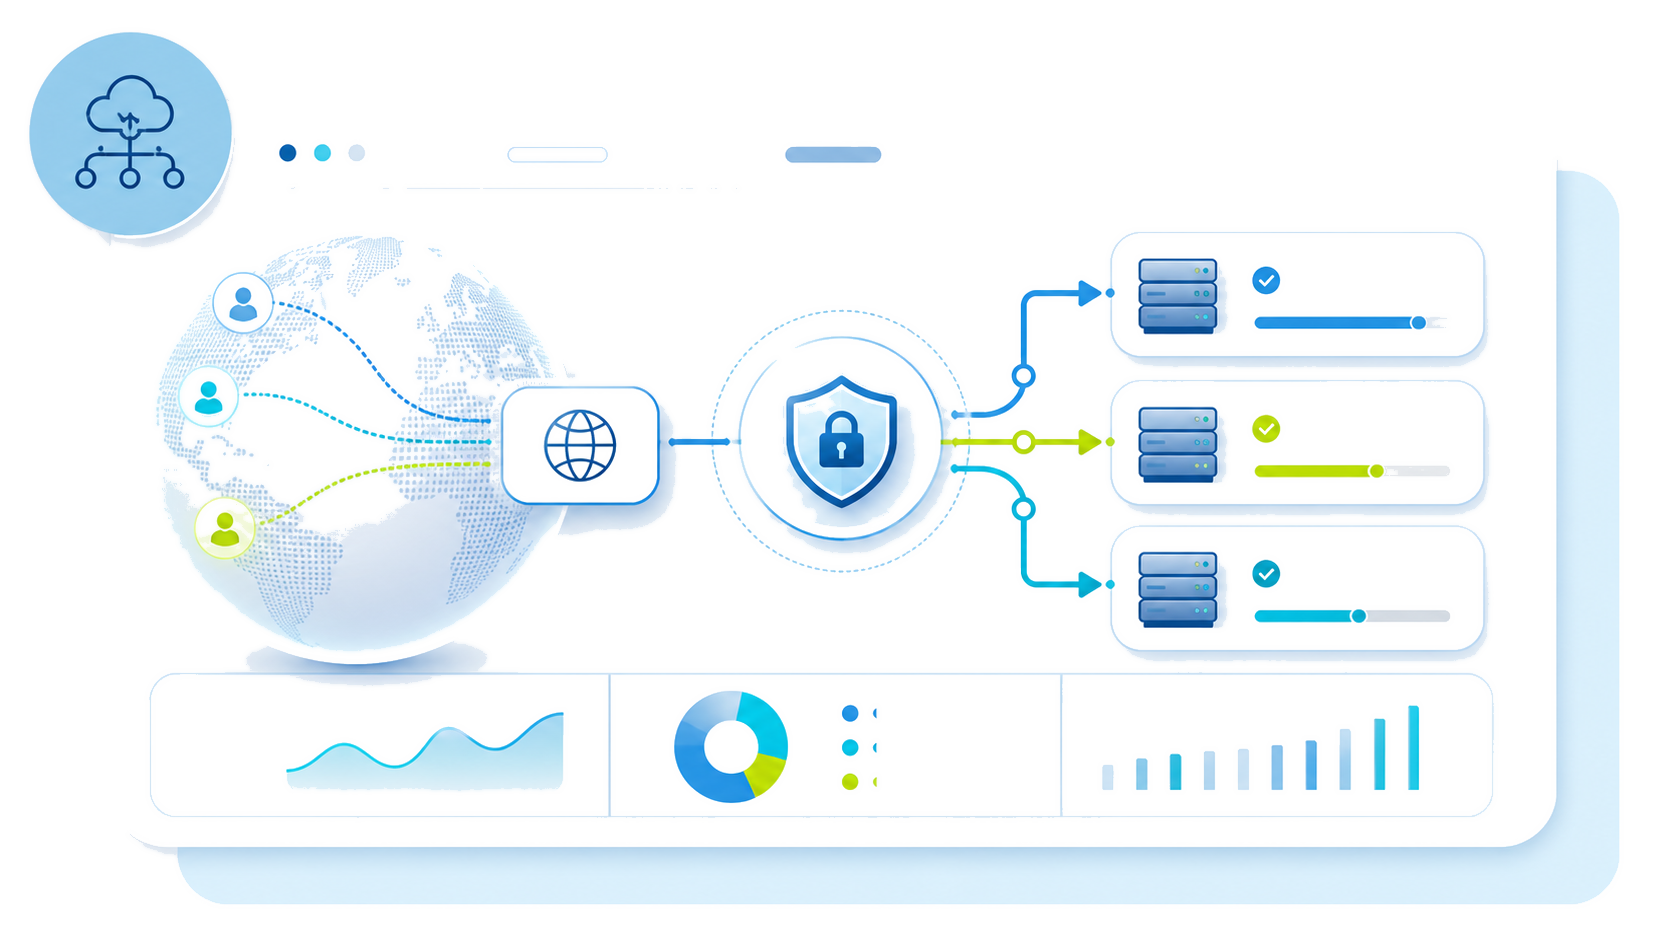
Maintenez vos services en ligne pendant les pics planifiés et la croissance inattendue. Placez un équilibreur de charge géré devant un parc d'instances de calcul à la demande, puis augmentez la capacité sans avoir à reconcevoir votre application au préalable. 
Noms de domaine illustration

Distinguez la demande réelle des attaques avant de procéder à la mise à l'échelle
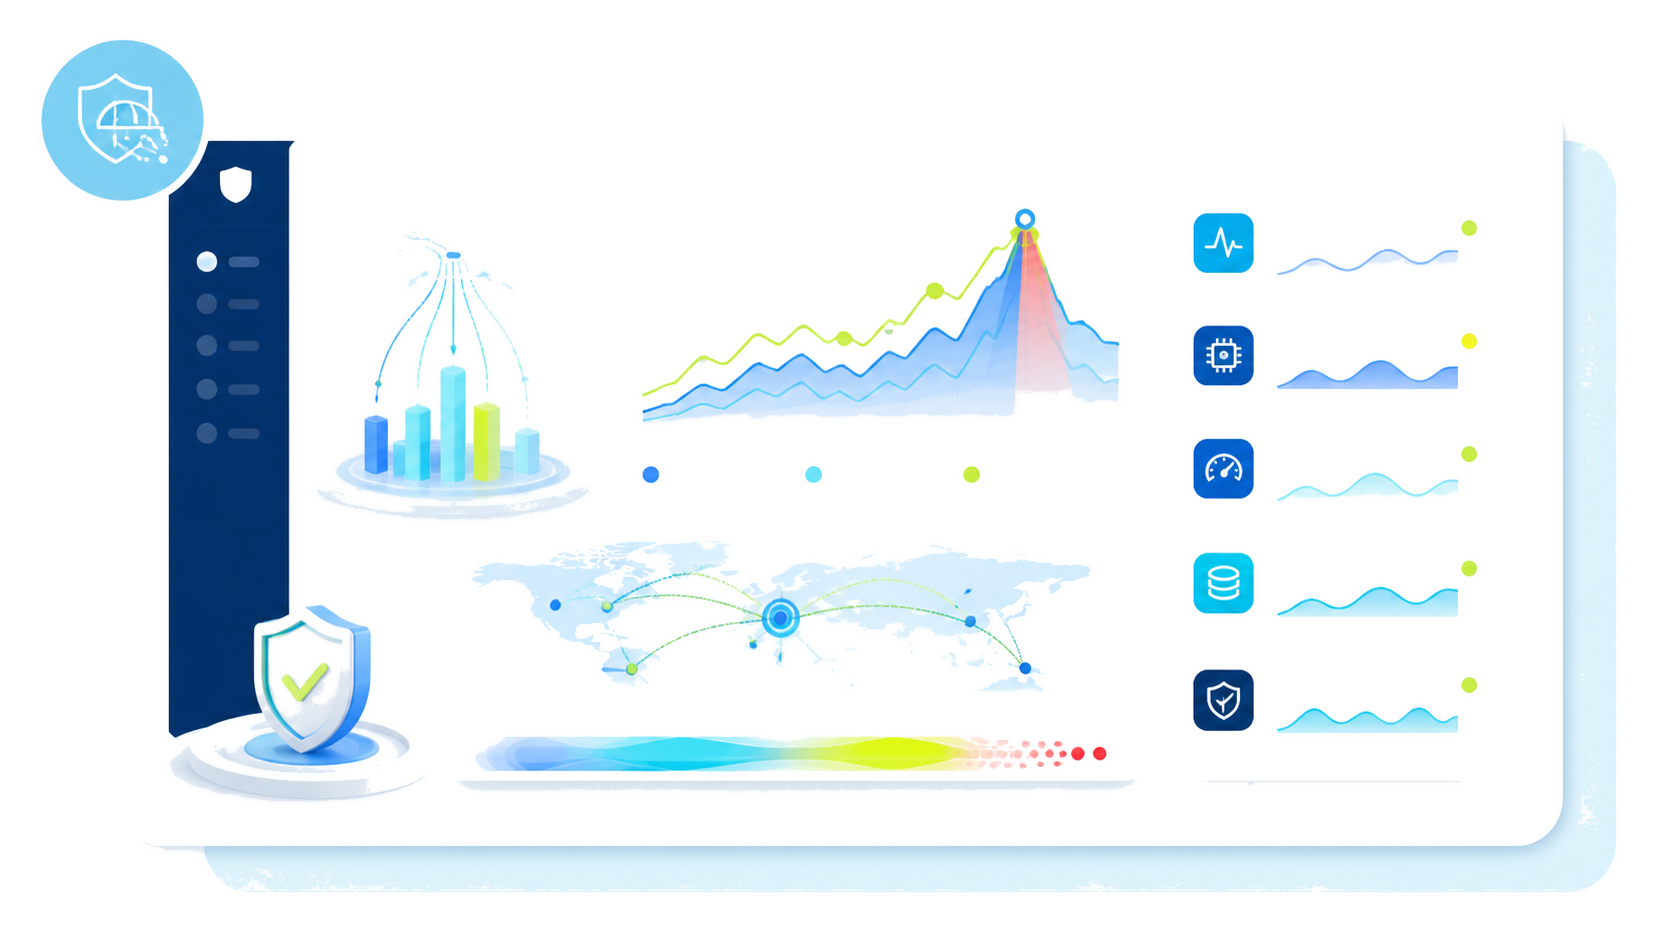
Lisez l'histoire derrière chaque pic de trafic soudain. Le taux de requêtes, le processeur, la latence et la forme du trafic fournissent la profondeur technique nécessaire pour détecter les vrais utilisateurs, les pannes ou les activités hostiles. Pour gérer les pics de trafic sans interruption, distribuez le trafic entrant, ajoutez de la capacité, utilisez la mise en cache et appliquez l'optimisation de la base de données. La protection anti-DDoS traite les flux malveillants. Cette compréhension aide à gérer les pics de trafic, à prévenir l'interruption du site web en cas de trafic élevé et à éviter les plantages ou un plantage inutile dû à une mise à l'échelle inappropriée.
[object Object]

Garanties mesurables pour les pics de trafic

Bénéficiez d'un SLA de 99,99 % pour le calcul et l'équilibrage de charge, ainsi que d'une protection anti-DDoS jusqu'à 10 Tbps
Engagement de service SLA de 99,99 %
Engagement de service de 99,99 %
Protection d'atténuation anti-DDoS
Atténuation incluse
Limites de capacité de charge
Limites de charge publiées

Renforcez la résilience du routage, du calcul et des données

Maintenez le mouvement des requêtes au point d'entrée

L'équilibreur de charge géré vérifie l'état du backend, termine le TLS et utilise le routage pondéré pour contrôler la distribution des requêtes. Si un serveur devient indisponible, le basculement automatique redirige les utilisateurs vers les nœuds disponibles.

Adaptez la capacité de calcul à la demande observée

Mettez à l'échelle un parc d'instances de calcul Gen3 identiques derrière la couche de routage. Choisissez la capacité à partir de modèles de trafic mesurés plutôt que d'hypothèses, puis ajoutez des nœuds par étapes contrôlées à mesure que la demande augmente. Lorsqu'une entreprise a besoin d'une résilience géographique, déployez sur trois zones de disponibilité à Paris ou à Milan.

Protéger la base de données contre la charge déplacée

Une capacité frontale supplémentaire peut exposer une contrainte de base de données au lieu de la résoudre. Protégez les pools de connexions, mettez en cache les données accédées appropriées en mémoire et inspectez les requêtes de recherche ou de paiement lentes avant de poursuivre la mise à l'échelle. Ces vérifications identifient les goulots d'étranglement potentiels que des nœuds d'application supplémentaires ne peuvent pas supprimer. La protection DDoS traite le trafic web hostile, tandis que cette architecture en couches gère les pics légitimes.

Préserver une adresse de service stable à chaque changement

OpenStack OctaviaIP flottanteTLS
OpenStack Octavia achemine les requêtes vers des backends sains, termine le TLS et utilise une distribution pondérée pour éviter qu'une machine virtuelle ne devienne le point de blocage. Une adresse IP flottante préserve l'adresse publique pendant que les équipes remplacent, redimensionnent ou basculent les ressources dans le délai imparti.

Sélectionnez des options basées sur les mesures de trafic, puis testez les performances dans des conditions de ventes flash et d'événements médiatiques. Ces stratégies aident à gérer les pics de trafic sans interruption de service et à protéger l'expérience utilisateur tout au long de la fenêtre de mise à l'échelle.
[object Object]
Une date de lancement connue donne aux équipes le temps de tester la configuration complète sous une forte demande représentative. Créez des instances de calcul temporaires à partir d'une image de référence réutilisable, validez les parcours client et utilisez l'équilibrage de charge pondéré pour introduire de la capacité avant l'arrivée des visiteurs. Cette stratégie est efficace pour le commerce saisonnier, les sorties de billets et la couverture médiatique programmée. Comme l'infrastructure supplémentaire est temporaire, l'entreprise évite de payer pour une marge statique inutilisée pendant les périodes plus calmes.

Une attention soudaine nécessite une réponse rapide et mesurée. Faites évoluer les instances de calcul à la demande, validez chaque nouveau nœud et distribuez le trafic entrant sur plusieurs serveurs sains. Appliquez une limitation de débit lorsqu'une ressource en aval rare, telle que l'authentification, l'inventaire ou le traitement des paiements, nécessite une protection. N'étendez pas automatiquement chaque dépendance : lisez les indicateurs de latence et d'erreur pour déterminer où se situe la contrainte.

L'hébergement à haute disponibilité nécessite une protection à la fois contre les changements de demande et les pannes de localisation. Une architecture multi-AZ réduit la dépendance à une seule zone de disponibilité, tandis qu'une capacité statique offre une marge de manœuvre immédiate pour les fluctuations courantes. Les équipes peuvent ensuite ajouter des ressources rapidement lorsque les conditions dépassent cette base de référence. Une fois le trafic normalisé, confirmez que les files d'attente, la latence et les erreurs restent stables avant de supprimer les nœuds temporaires.
Une date de lancement connue donne aux équipes le temps de tester la configuration complète sous une forte demande représentative. Créez des instances de calcul temporaires à partir d'une image de référence réutilisable, validez les parcours client et utilisez l'équilibrage de charge pondéré pour introduire de la capacité avant l'arrivée des visiteurs. Cette stratégie est efficace pour le commerce saisonnier, les sorties de billets et la couverture médiatique programmée. Comme l'infrastructure supplémentaire est temporaire, l'entreprise évite de payer pour une marge statique inutilisée pendant les périodes plus calmes.

Rendez chaque réponse à une augmentation répétable

Base de référence de capacité

Effectuez des tests de charge sur les principaux parcours utilisateur et enregistrez les points où les performances de calcul, réseau ou de base de données deviennent surchargées. Cette base de référence soutient un plan réaliste basé sur la demande actuelle.

Construction réutilisable

Maintenez un instantané d'instance testé ou une image de référence. Chaque nouveau nœud peut alors partager la même configuration d'application, de sécurité et de réseau.

Visibilité opérationnelle

Mettez en place une surveillance avant un événement pour le volume de requêtes, la latence, les erreurs, le processeur, les connexions et les données fréquemment consultées. Les alertes aident les équipes à réagir plus rapidement à une demande inattendue.

Maturité de la mise à l'échelle

Utilisez l'expansion de VM scriptée pour gérer les pics de trafic ou une augmentation soudaine liée aux réseaux sociaux.

Déployez la protection contre les augmentations soudaines via quatre flux de travail

Établir une base de référence et protéger

Quantifiez le trafic attendu et soudain, définissez les objectifs de service et effectuez des tests de charge sur les chemins critiques. Confirmez que l'atténuation des attaques est active afin que les équipes puissent gérer une demande accrue sans confondre l'activité hostile avec une croissance légitime.

Construire et automatiser

Décrivez la configuration du parc, du réseau et de l'équilibrage avec Terraform. Un code d'infrastructure reproductible aide les ingénieurs à ajouter de la capacité de manière cohérente en quelques minutes ou heures, au lieu de reconstruire manuellement les serveurs pendant un incident.

Validez les données et l'expérience

Testez les connexions à la base de données, les taux d'erreur et les temps de chargement en cas d'augmentation du trafic. Incluez les pannes de nœuds et de zones pour confirmer que l'architecture maintient une expérience utilisateur fluide lorsque des composants individuels deviennent indisponibles.

Exploitez et récupérez

Documentez les déclencheurs de mise à l'échelle, les chemins d'approbation et de contact, les conseils de restauration et la propriété. Définissez quand il est sûr de supprimer la capacité temporaire après un moment viral, en vous basant sur la santé stable du service plutôt que sur la première baisse de trafic.

Supprimez la capacité temporaire lorsque les performances se stabilisent
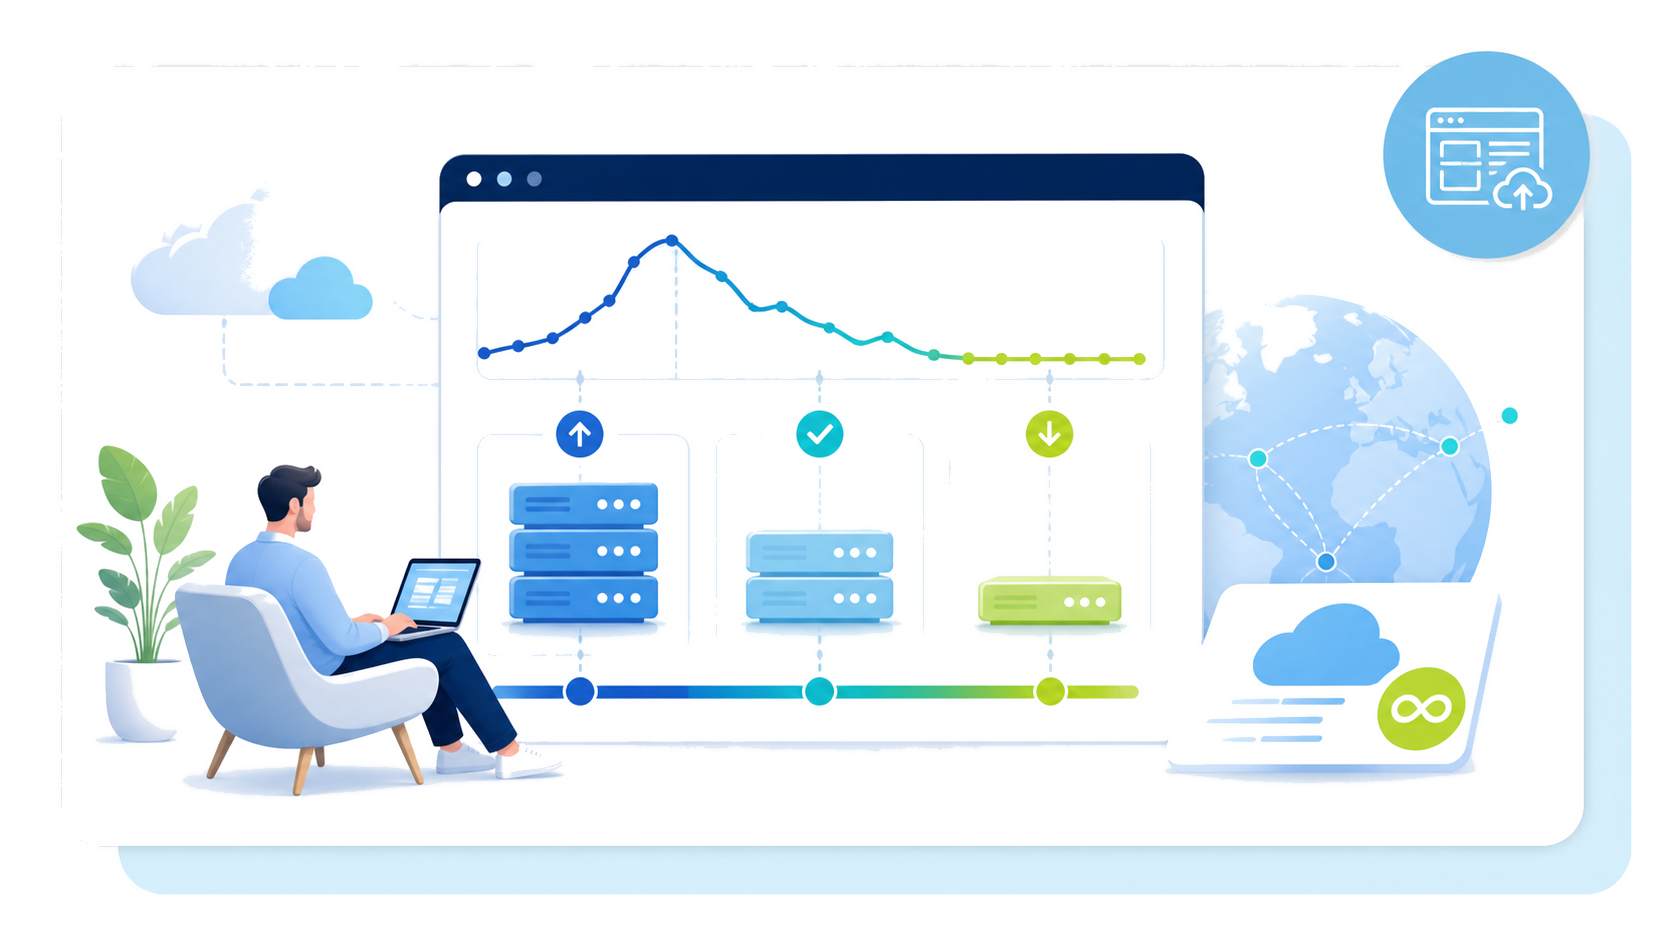
La facturation à la seconde des instances de calcul, avec un minimum de 60 secondes à partir de mai 2026, aligne la capacité temporaire sur chaque pic. Observez le moment où la demande applicative revient à la normale, où la file d'attente des requêtes se vide et où la vitesse du service se stabilise avant de supprimer efficacement les nœuds excédentaires. Cette approche mesurée permet de garantir le contrôle des coûts sans risquer de pannes. Le trafic sortant illimité et non facturé dans la plupart des régions peut réduire l'incertitude inutile pour l'hébergement cloud riche en contenu ; vérifiez la disponibilité régionale et les conditions pour votre entreprise.
[object Object]
Préparez votre infrastructure avant la prochaine montée en charge
Démarrez un essai Public Cloud ou activez un équilibreur de charge géré. Déployez, testez et affinez votre réponse avant que la demande n'augmente.
Activez l'équilibreur de charge